缓存组件 (Cache)
API文档
https://tech.rydeen.com.cn/apidocs/cache/4.6.0/index.html
服务器缓存组件作用
本组件是对缓存技术的封装,并屏蔽了具体缓存中间件对业务代码的影响。目前支持的缓存中间件有:Redis、Ehcache
。未来会支持更多的缓存中间件技术,而使用者仅需在配置文件中指定使用的缓存中间件即可,无需修改业务代码。且本组件提供了静态工具类,方便使用者在业务代码中直接调用。而无须创建缓存管理器、缓存对象等,简化了缓存的使用。Redis缓存中提供了分布式锁的功能,方便使用者在分布式环境下使用锁,分布式锁除了常用的Redisson
外,还提供了基于Redis的分布式锁实现CacheLock,使用也非常简单。
服务器缓存组件用法
Config配置文件
Redis缓存服务依赖于spring-boot-starter-data-redis,使用时需要在application.yml
中配置Redis的连接信息,同时我们还对Redis连接客户端的功能和配置做了扩展,在使用Linux系统的时候可以利用Linux
Kernel的Epoll机制来提高Redis连接的性能,以及连接的保活,后续章节中会对新增的功能进行具体说明。
下面是一个简单的Redis配置示例,实际生产使用时请根据实际业务情况对配置信息进行调整:
单机模式
注意:云PAAS服务的Redis,通常是通过代理服务地址伪装成单机模式,所以如果采用的Redis是云PAAS服务,则默认请使用单机模式配置。
spring:
  cache:
    redis:
      # 不允许缓存null值
      cache-null-values: false
  data:
    # Redis连接配置
    redis:
      # Redis服务类型(根据此处的设置来确定下方使用哪种模式,可用值:standalone、sentinel、cluster)
      server-type: standalone
      # Redis客户端名称
      client-name: boh-redis
      # Redis客户端类型
      client-type: lettuce
      # Redis 主机地址
      host: 10.100.0.87
      # Redis 主机端口
      port: 6379
      # Redis 主机密码
      password: 123456
      # 连接的库索引
      database: 15
      # 读取超时时间
      timeout: 2000
      # 连接超时时长
      connect-timeout: 5000
      # 是否启用SSL
      ssl:
        # 是否启用
        enabled: false
        # 是否信任自签名证书(请根据实际情况配置)
        bundle: self-signed
      # lettuce 配置
      lettuce:
        # 连接池配置
        pool:
          # 是否启用连接池
          enabled: true
          # 连接池最大连接数(使用负值表示没有限制)
          max-active: 100
          # 连接池中的最大空闲连接
          max-idle: 10
          # 连接池中的最小空闲连接
          min-idle: 5
          # 连接池最大阻塞等待时间(使用负值表示没有限制)
          max-wait: 10000
          # 空闲连接回收的时间间隔,与test-while-idle一起使用,设置5分钟
          time-between-eviction-runs: 300000
哨兵模式
spring:
  cache:
    redis:
      # 不允许缓存null值
      cache-null-values: false
  data:
    # Redis连接配置
    redis:
      # Redis服务类型(根据此处的设置来确定下方使用哪种模式,可用值:standalone、sentinel、cluster)
      server-type: sentinel
      # Redis客户端名称
      client-name: boh-redis
      # Redis客户端类型
      client-type: lettuce
      # Redis 主机密码
      password: 123456
      # 连接的库索引
      database: 15
      # 读取超时时间
      timeout: 2000
      # 连接超时时长
      connect-timeout: 5000
      # 哨兵配置
      sentinel:
        # 哨兵主节点名称
        master: template-master
        # 哨兵节点列表
        nodes:
          - 10.200.0.97:86379
          - 10.200.0.98:86379
          - 10.200.0.99:86379
        # 哨兵主节点密码
        password: rydeen12345
      # SSL配置
      ssl:
        # 是否启用
        enabled: false
        # 是否信任自签名证书(请根据实际情况配置)
        bundle: self-signed
      # lettuce 配置
      lettuce:
        # 连接池配置
        pool:
          # 是否启用连接池
          enabled: true
          # 连接池最大连接数(使用负值表示没有限制)
          max-active: 100
          # 连接池中的最大空闲连接
          max-idle: 10
          # 连接池中的最小空闲连接
          min-idle: 5
          # 连接池最大阻塞等待时间(使用负值表示没有限制)
          max-wait: 10000
          # 空闲连接回收的时间间隔,与test-while-idle一起使用,设置5分钟
          time-between-eviction-runs: 300000
集群模式
spring:
  cache:
    redis:
      # 不允许缓存null值
      cache-null-values: false
  data:
    # Redis连接配置
    redis:
      # Redis服务类型(根据此处的设置来确定下方使用哪种模式,可用值:standalone、sentinel、cluster)
      server-type: cluster
      # Redis客户端名称
      client-name: boh-redis
      # Redis客户端类型
      client-type: lettuce
      # Redis 主机密码
      password: 123456
      # 连接的库索引
      database: 15
      # 读取超时时间
      timeout: 2000
      # 连接超时时长
      connect-timeout: 5000
      # 集群配置
      cluster:
        # Redis节点
        nodes:
          - 10.200.0.97:86379
          - 10.200.0.98:86379
          - 10.200.0.99:86379
          - 10.200.0.100:86379
          - 10.200.0.101:86379
          - 10.200.0.102:86379
          - 10.200.0.103:86379
          - 10.200.0.104:86379
        # 最大重定向数
        max-redirects: 8
      # SSL配置
      ssl:
        # 是否启用
        enabled: false
        # 是否信任自签名证书(请根据实际情况配置)
        bundle: self-signed
      # lettuce 配置
      lettuce:
        # 连接池配置
        pool:
          # 是否启用连接池
          enabled: true
          # 连接池最大连接数(使用负值表示没有限制)
          max-active: 100
          # 连接池中的最大空闲连接
          max-idle: 10
          # 连接池中的最小空闲连接
          min-idle: 5
          # 连接池最大阻塞等待时间(使用负值表示没有限制)
          max-wait: 10000
          # 空闲连接回收的时间间隔,与test-while-idle一起使用,设置5分钟
          time-between-eviction-runs: 300000
多Redis环境
spring:
  cache:
    redis:
      # 不允许缓存null值
      cache-null-values: false
  data:
    # Redis连接配置
    redis:
      # Redis服务类型(根据此处的设置来确定下方使用哪种模式,可用值:standalone、sentinel、cluster)
      server-type: standalone
      # Redis客户端名称
      client-name: boh-redis
      # Redis客户端类型
      client-type: lettuce
      # Redis 主机地址
      host: 10.100.0.87
      # Redis 主机端口
      port: 6379
      # Redis 主机密码
      password: 123456
      # 连接的库索引
      database: 15
      # 读取超时时间
      timeout: 2000
      # 连接超时时长
      connect-timeout: 5000
      # Slave节点配置
      slaves:
          [实例2别名]:
              # Redis服务类型(根据此处的设置来确定下方使用哪种模式,可用值:standalone、sentinel、cluster)
              server-type: standalone
              # Redis客户端名称
              client-name: [slave客户端名称]
              # Redis客户端类型
              client-type: lettuce
              # Redis 主机地址
              host: 10.100.0.87
              # Redis 主机端口
              port: 6379
              # Redis 主机密码
              password: 123456
              # 连接的库索引
              database: 15
              # 读取超时时间
              timeout: 2000
              # 连接超时时长
              connect-timeout: 5000
          [实例3、4、5...n别名]:
              # ......
      # 是否启用SSL
      ssl:
        # 是否启用
        enabled: false
        # 是否信任自签名证书(请根据实际情况配置)
        bundle: self-signed
      # lettuce 配置
      lettuce:
        # 连接池配置
        pool:
          # 是否启用连接池
          enabled: true
          # 连接池最大连接数(使用负值表示没有限制)
          max-active: 100
          # 连接池中的最大空闲连接
          max-idle: 10
          # 连接池中的最小空闲连接
          min-idle: 5
          # 连接池最大阻塞等待时间(使用负值表示没有限制)
          max-wait: 10000
          # 空闲连接回收的时间间隔,与test-while-idle一起使用,设置5分钟
          time-between-eviction-runs: 300000
在代码中使用slave节点的时候,使用[实例n别名]@@[key]的方式编写KEY,就可以从对应的slave节点中获取缓存数据,访问主缓存的方式无特殊要求。直接用key获取即可。
例:
UserInfoVO userInfoVO = GlobalCache.getObjectCache("实例2别名@@platform:user:12345", UserInfoVO.class);
Lettuce连接池
Redis缓存中间件默认采用的Lettuce客户端,Jedis理论上属于Redis直连模式,并非连接池技术,所以不推荐使用。
Lettuce是一个高性能的异步驱动的Redis Java客户端,它的特点是线程安全、高效、易用,支持同步、异步、响应式模式,支持Redis Sentinel、Redis Cluster、连接池等特性。
连接池中的参数配置在上一个章节中仅仅是提供的配置模板,实际生产环境中需要根据实际情况进行调整,以达到最佳的性能和稳定性。连接池配置无法给出标准配置,因为这些参数受到Redis服务器性能、网络带宽、并发访问量等多种因素的影响,所以需要根据实际情况进行调整。
我们推荐的调整方式是:先根据从客户处统计到的业务并发量、访问量、服务器性能等因素进行一个初步的配置,然后通过压测工具进行压测,根据压测结果进行调整,以达到最佳的性能和稳定性。
除此之外,Lettuce的新版本中还支持了Linux Kernel的Epoll机制,以及连接的保活,以提高Redis连接的性能,在生产环境中使用能极大的提升连接的稳定性和访问性能。具体配置方式请参考下面的章节。
Epoll连接模式
-
本章节特性仅Linux系统支持,其他系统不可用。可在生产环境中配置使用,以提高Redis连接的性能和稳定性。 :::
什么是Epoll
epoll是Linux内核中用于处理大量文件描述符的改进型poll系统调用,它是Linux下多路复用IO接口select/poll的增强版本,用于提高程序在大量并发连接中只有少量活跃情况下的系统CPU利用率。
epoll的主要优势在于它能够同时处理大量的文件描述符,而不会随着文件描述符数量的增加而降低效率。epoll通过在内核与用户空间之间共享一个事件表来工作,这个事件表中存放着所有需要监控的文件描述符及其状态。当文件描述符的状态发生变化时,如可读或可写,内核会将这个事件通知给用户空间,用户空间再根据事件类型进行相应的处理。
此外,epoll还支持水平触发(Level Triggered)和边缘触发(Edge Triggered) 两种模式,其中水平触发模式会持续发送事件信号,直到文件描述符的状态发生变化;而边缘触发模式只在文件描述符状态变化时发送事件信号。
Epoll的优点
select最不能忍受的是一个进程所打开的FD是有一定限制的,由FD_SETSIZE设置,默认值是2048。对于那些需要支持的上万连接数目的IM服务器来说显然太少了。这时候你一是可以选择修改这个宏然后重新编译内核,不过资料也同时指出这样会带来网络效率的下降,二是可以选择多进程的解决方案(传统的 Apache方案),不过虽然linux上面创建进程的代价比较小,但仍旧是不可忽视的,加上进程间数据同步远比不上线程间同步的高效,所以也不是一种完美的方案。不过epoll则没有这个限制,它所支持的FD上限是最大可以打开文件的数目,这个数字一般远大于2048,举个例子,在1GB内存的机器上大约是10万左右,具体数目可以cat/proc/sys/fs/file-max察看,一般来说这个数目和系统内存关系很大。
传统的select/poll另一个致命弱点就是当你拥有一个很大的socket集合,不过由于网络延时,任一时间只有部分的socket是"活跃"的,但是select/poll每次调用都会线性扫描全部的集合,导致效率呈现线性下降。但是epoll不存在这个问题,它只会对"活跃"的socket进行操作---这是因为在内核实现中epoll是根据每个fd上面的callback函数实现的。那么,只有"活跃"的socket才会主动的去调用callback函数,其他idle状态socket则不会,在这点上,epoll实现了一个"伪"AIO,因为这时候推动力在os内核。在一些benchmark中,如果所有的socket基本上都是活跃的---比如一个高速LAN环境,epoll并不比select/poll有什么效率,相反,如果过多使用epoll_ctl,效率相比还有稍微的下降。但是一旦使用idle connections模拟WAN环境,epoll的效率就远在select/poll之上了。
这点实际上涉及到epoll的具体实现了。无论是select,poll还是epoll都需要内核把FD消息通知给用户空间,如何避免不必要的内存拷贝就很重要,在这点上,epoll是通过内核于用户空间mmap同一块内存实现的。而如果你想我一样从2.5内核就关注epoll的话,一定不会忘记手工mmap这一步的。
这一点其实不算epoll的优点了,而是整个linux平台的优点。也许你可以怀疑linux平台,但是你无法回避linux平台赋予你微调内核的能力。比如,内核TCP/IP协议栈使用内存池管理sk_buff结构,那么可以在运行时期动态调整这个内存pool(skb_head_pool)的大小--- 通过echo XXXX>/proc/sys/net/core/hot_list_length完成。再比如listen函数的第2个参数(TCP完成3次握手的数据包队列长度),也可以根据你平台内存大小动态调整。更甚至在一个数据包面数目巨大但同时每个数据包本身大小却很小的特殊系统上尝试最新的NAPI网卡驱动架构。
使用和保活配置
介于新版本Lettuce连接客户端支持了全新的Linux Epoll特性,其比传统的select、poll等I/O多路复用技朮更加高效,所以我们 在Linux系统下做了更高级的性能优化,加入了Linux Kernel的Epoll机制,以及连接的保活,以提高Redis连接的性能,在生产环境中使用能极大的提升连接的稳定性和访问性能。具体配置方式如下:
spring:
  data:
    # Redis连接配置
    redis:
      # Lettuce配置
      lettuce:
        # 客户端连接保活策略配置(采用Linux的Epoll模型,仅支持Linux x86_64、aarch64 和 riscv64 版本,其他系统不可用)
        # 在非Linux系统下会收到lettuce的⚠️警告日志,无法应用该配置用于Socket通道
        keep-alive:
          # 是否启用保活策略
          enabled: true
          # TCP连接在彻底断开前至少发送的探针数量
          count: 6
          # 探针检测空闲连接时长
          idle: 90
          # 探针检测空闲连接时长单位
          idle-unit: seconds
          # 探针检测间隔时长
          interval: 60
          # 探针检测间隔时长单位
          interval-unit: seconds
          # TCP用户超时阈值时长
          #(Netty推荐配置该值的公式:idle + count * interval【请勿乱配】
          # 过于密集影响服务器性能,过于稀疏可能起不到效果)
          tcp-user-timeout: 450
          # TCP用户超时阈值时长单位
          tcp-user-timeout-unit: seconds
配合上面的基本配置,即可实现在Linux系统下的高性能Socket连接了。
GlobalCache的使用
GlobalCache是一个静态工具类,其是对cn.com.rydeen.component.cache.redis.manage.GlobalCacheManager的封装,使用者无需关心具体的缓存管理器、缓存对象等,只需要直接调用GlobalCache的方法即可。本组件对Redis作为缓存使用时常用的数据类型(string, hash, list, set, zset)进行了封装,使用者可以直接调用GlobalCache的方法来操作这些数据类型。具体API请参考下面的Javadoc。
- Javadoc: 查看GlobalCache API
低性能API接口
由于本组件同时服务于多个业务系统,为了防止面向ToC的系统使用到时间复杂度较高的API接口,我们对低性能API接口从GlobalCache中移除,并在其中提供了一个getLowPerformenceApi()方法用于获取低性能API接口的集合,该接口仅供ToB系统使用(比如:BOH),ToC系统请勿使用。在4.3.0版本之前,如果使用了GlobalCache中的低性能接口方法的,在升级到4.3.0版本后,这些方法会提示不存在,使项目无法通过编译,请尽快使用正确的缓存数据结构改写代码,以免影响系统性能,以及项目的后续迭代。
以下是低性能API接口的列表:
package cn.com.rydeen.component.cache.redis.manage;

import java.util.Collection;
import java.util.Map;
import java.util.NavigableSet;
import java.util.Set;

/**
 * 低性能API接口
 * <p>注意:FOH和O2O的所有项目,严禁使用本API接口下的任何方法,该接口的所有方法都是低性能的,不建议在高性能场景和toC业务场景下使用,否则将造成Redis服务器的严重性能损耗</p>
 *
 * @author richie696
 * @version 1.0
 * @since 2024-10-19 01:09:14
 */
public interface LowPerformanceApi {

    /**
     * 获取指定节点下的所有KEY的方法
     *
     * @param key 需要获取的某组KEY的父节点
     * @return 返回该父节点下的所有子节点KEY
     */
    Set<String> getAllKeys(String key);

    /**
     * 根据Key列表删除指定元素的方法
     *
     * @param parentKey 父节点KEY列表
     */
    void batchRemoveCache(String parentKey);


    /**
     * 模糊匹配指定关键字的对象列表的方法
     *
     * @param match 模糊匹配的缓存键表达式
     * @param count 指定获取的条数
     * @param clazz 返回值类型
     * @param <T>   接收返回值使用的泛型类型
     * @return 返回符合条件的对象集合
     */
    <T> Map<String, T> fuzzy(String match, int count, Class<T> clazz);


    /**
     * 查询给定的Set集合的差集并返回差集的方法
     *
     * @param keys 待比较的资源键列表
     * @return 返回资源值集合
     */
    <T> Set<T> differenceFromSet(Collection<String> keys, Class<T> clazz);

    /**
     * 查询给定的Set集合的差分结果并返回的方法
     *
     * @param key       用于比较的主键
     * @param otherKeys 待比较的资源键列表
     * @return 返回资源值集合
     */
    <T> Set<T> differenceFromSet(String key, Collection<String> otherKeys, Class<T> clazz);

    /**
     * 查询给定的Set集合的差集并保存到目标键位置的方法
     *
     * @param compareKeys 待比较的资源键列表
     * @param destKey     目标资源键
     * @return 返回目标资源键内的元素数量
     */
    Long differenceAndStoreFromSet(Collection<String> compareKeys, String destKey);

    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的交集并返回的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param clazz     目标缓存类型
     * @param <T>       接收返回值使用的泛型类型
     * @return 返会并集的元素数量
     */
    <T> NavigableSet<T> intersectFromZSet(String key, Collection<String> otherKeys, Class<T> clazz);

    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的并集并存储到目标 Key 的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param clazz     目标缓存类型
     * @param <T>       接收返回值使用的泛型类型
     * @return 返会并集的元素数量
     */
    <T> NavigableSet<T> unionFromZSet(String key, Collection<String> otherKeys, Class<T> clazz);


    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的并集并存储到目标 Key 的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param destKey   目标元素KEY
     * @return 返会并集的元素数量
     */
    Long unionAndStoreFromZSet(String key, Collection<String> otherKeys, String destKey);

    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的交集并存储到目标 Key 的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param destKey   目标元素KEY
     * @return 返会交集的元素数量
     */
    Long intersectAndStoreFromZSet(String key, Collection<String> otherKeys, String destKey);

    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的差集并存储到目标 Key 的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param destKey   目标元素KEY
     * @return 返会交集的元素数量
     */
    Long differenceAndStoreFromZSet(String key, Collection<String> otherKeys, String destKey);

    /**
     * 获取指定 Key 和用于比较的 OtherKeys 的差集的方法
     *
     * @param key       元素KEY
     * @param otherKeys 其他元素KEY列表
     * @param clazz     目标缓存类型
     * @param <T>       接收返回值使用的泛型类型
     * @return 返会交集的元素数量
     */
    <T> NavigableSet<T> differenceFromZSet(String key, Collection<String> otherKeys, Class<T> clazz);
}
对象类型存储说明
在使用GlobalCache存储对象类型时,需要注意以下几点:
- 不要将复杂的嵌套对象类型往Redis中直接存储,这样会导致Redis存储的数据量过大,在频繁的存取操作中会影响Redis和Java程序的性能,建议将复杂对象类型拆分成多个简单的对象类型存储。如果实在无法在Redis中做拆分,请将此类对象存储到MongoDB中,并在MongoDB中建立合适的索引,以提升查询性能。然后在Redis中存储MongoDB中的文档ID,以便在需要时从MongoDB中获取数据。
- 简单类型的对象在存入Redis时,请使用
GlobalCache的addObjectToHash方法,讲对象分解为Hash格式存储到Redis中,好处是如果只需要获取对象中的某个属性值时可以利用GlobalCache中提供的访问HashValue的API方法进行单个属性的查询或修改,而不需要将整个对象取出来再进行操作,这样也减少了应用服务器序列化和反序列化的压力,降低Redis和应用服务器的CPU负载。 GlobalCache中的addObjectCache和getObjectCache方法已经被标注为@Deprecated,不建议使用,建议使用addObjectToHash和getObjectFromHash方法进行对象的存取操作,被废弃的方法将会在4.4.0版本框架中已经彻底的移除。
CacheLock的使用
CacheLock是一个基于Redis的分布式锁实现,使用也非常简单,只需要在需要加锁的代码块中通过GlobalCache创建CacheLock
对象即可,如下所示:
try (var lock = GlobalCache.lock(key, time)) {
    if (!lock.isSuccess()) {
        return ResultVO.getError("获取分布式锁失败。");
    }
    if (GlobalCache.hasKey(key)) {
        return ResultVO.getError("当前数据已被其他线程写入,缓存写入失败。");
    }
    // to do something
}
CacheLock锁实现了AutoCloseable接口,所以可以使用try-with-resources语法来自动释放锁,这样可以避免因为业务代码异常而导致锁无法释放的情况。
- Javadoc: 查看CacheLock API
CacheBatchLock的使用
CacheBatchLock是一个基于Redis的分布式批量锁实现,只需要在需要加锁的代码块中通过GlobalCache创建CacheBatchLock
对象即可,如下所示:
Collection<String> keys = Set.of("key1", "key2", "key3", "keyN");
long timeout = 20000L;
TimeUnit unit = TimeUnit.MINUTES;
try (var lock = GlobalCache.batchLock(keys, timeout, unit)) {
    if (!lock.isSuccess()) {
        return ResultVO.getError("获取分布式锁失败。");
    }
    if (GlobalCache.hasKey(key)) {
        return ResultVO.getError("当前数据已被其他线程写入,缓存写入失败。");
    }
    // to do something
}
- Javadoc: 查看CacheBatchLock API
可指定过期时间的@Cacheable注解的使用
@Cacheable注解是Spring提供的一个注解,用于声明一个方法的返回结果应该被缓存,以便后续的调用可以直接从缓存中获取结果,而无需再次执行方法。
使用@Cacheable注解时,需要在方法上添加@Cacheable注解,并指定缓存的名称,但Spring提供的@Cacheable注解只能支持全局缓存过期,无法指定单个缓存的过期时间,所以我们提供了@Cacheable的增强版,加入了对单个缓存的过期时间的支持,使用者可以在@Cacheable注解中使用#xxx(单位:秒)指定缓存的过期时间,如下所示:
// 缓存名称为:platform:users:info,缓存过期时间为:7200秒
@Cacheable(value = "platform:users:info#7200", key = "#id", unless = "#result.data == null ")
public ResultVO<?> getUserInfoVO(Long id) {
    // to do something
}
API接口能力和最佳实践
接口能力梳理
适合toC业务系统的接口
- 高频小数据KV缓存:如验证码、会话、用户状态、配置、和不超过20个字段的小对象,且对象内保存的都是基本数据类型和非超长的String字符串等
addStringCache/getStringCacheaddIntCache/getIntCacheaddBooleanCache/getBooleanCacheincrement/decrementsetExpiredTimeremoveCache- 分布式锁相关:
optimisticLock、pessimisticLock等
不适合toC业务系统的接口
- 大对象/大集合存储(如序列化后的复杂对象、图片、视频、长列表等)
addListCache/getListCache(简单值除外)addSetCache/getSetCache(简单值除外)addObjectToHash/getObjectFromHash(简单值除外)batchAddToList、batchAddToSet、batchAddToHash等 (简单值除外)
- 批量大数据操作(高并发下大批量同步)
- 不设置过期时间的缓存(如addXXXCache无timeout参数的重载)
集合类型元素数量最佳实践与阈值配置
官方建议与社区经验
- Redis官方没有强制的集合元素数量上限,但实际生产环境中,单个集合(list、set、zset、hash)元素数量过大,会带来严重性能隐患,如阻塞、慢查询、主从同步延迟、AOF重写卡顿等。
- 最佳实践是:单个集合的元素数量应控制在合理范围内,避免“大key”现象。
推荐阈值(经验值)
| 类型 | 推荐单集合最大元素数 | 说明 |
|---|---|---|
| list | 5,000 ~ 10,000 | 超过后操作如lrange、ltrim、lpop等会变慢,阻塞主线程 |
| set | 5,000 ~ 10,000 | sismember、smembers等操作会变慢 |
| zset | 5,000 ~ 10,000 | zrange、zremrangebyrank等操作会变慢 |
| hash | 5,000 ~ 10,000 | hgetall、hkeys等操作会变慢 |
| string | - | 主要关注value大小,建议单value不超过10KB,最大不要超过200KB(当超过建议值以后尽量减少云端反序列化操作) |
如果集合元素是大对象,建议阈值更低。对于极端高并发或大数据场景,建议分片或拆分集合。
典型隐患
- 大key阻塞:如lrange、smembers、hgetall等操作会阻塞Redis主线程,影响所有请求。
- 主从同步延迟:大key同步慢,主从延迟,甚至阻塞。
- AOF重写卡顿:大key导致AOF重写耗时剧增。
- 慢查询:客户端操作大key时容易出现慢查询,影响业务响应。
最佳实践建议
- 单集合元素数建议不超过5,000~10,000,如有特殊需求需评估性能影响。
- 避免使用全量操作(如lrange、smembers、hgetall、zrange等)在大集合上,优先分页、游标遍历。
- 业务层限制写入,如超阈值则分片、拆分集合或拒绝写入。
- 定期扫描大key并告警,及时处理。
- 大数据量场景建议用专用中间件(如MongoDB、HBase、ES等),Redis只做热点小数据缓存。
使用注意事项与隐患
| 场景 | 错误用法 | 可能隐患 | 正确用法建议 |
|---|---|---|---|
| 存储大对象 | 用string/hash/list/set存储序列化大对象 | Redis内存膨胀、主从同步阻塞、缓存雪崩、GC压力大、网络IO瓶颈,甚至Redis进程崩溃 | 仅存储小型、结构简单、频繁访问的数据。大对象建议用MongoDB、HBase、ES等 |
| 永不过期缓存 | 不设置过期时间 | 数据脏读、缓存污染、内存泄漏 | 必须设置合理的过期时间,防止缓存雪崩 |
| 批量操作 | 大批量写入/读取 | Redis阻塞、主从延迟、业务卡顿 | 拆分批量操作,控制单次操作量,必要时用消息队列异步处理 |
| 分布式锁 | 锁粒度过大/锁时间过长 | 死锁、业务阻塞 | 合理设计锁粒度和超时时间,避免死锁 |
| 复杂业务逻辑 | 直接用缓存做业务一致性 | 数据不一致、难以追踪 | 缓存只做加速,核心数据落地DB,必要时用消息队列/事件总线保证一致性 |
大对象序列化存储的风险与建议
风险
- 内存占用高:Redis是内存数据库,大对象会极大消耗内存,影响整体性能。
- 主从同步慢:大对象同步会拖慢主从复制,导致主从延迟甚至阻塞。
- 网络IO瓶颈:大对象传输占用带宽,影响其他请求。
- GC压力大:频繁存取大对象会导致Redis进程GC压力增大,甚至频繁Full GC。
- 缓存雪崩/击穿:大对象过期或失效时,瞬间大量请求打到DB,造成雪崩。
建议
- Redis只存小对象:如会话、验证码、热点配置、计数器等。
- 大对象用专用中间件:
- MongoDB:适合文档型、半结构化数据,支持大对象(如JSON、图片、文件等)。
- HBase:适合超大体量、宽表、历史归档数据。
- Elasticsearch:适合全文检索、日志、分析型数据。
- 对象存储(如OSS、S3):适合图片、视频、文件等二进制大对象。
- 缓存分层:本地缓存(如Caffeine/Guava)+ Redis + DB/NoSQL,提升性能和容错。
不同类型和体量数据的存储最佳实践
| 数据类型 | 体量 | 推荐存储 | 说明 |
|---|---|---|---|
| 热点KV | 小 | Redis | 低延迟、高并发 |
| 热点计数/状态 | 小 | Redis | 适合计数器、限流、状态标记 |
| 会话/Token | 小 | Redis | 适合高并发、短时效 |
| 配置/字典 | 小 | Redis/本地缓存 | 频繁读、偶尔变更 |
| 结构化业务数据 | 大 | MySQL/PostgreSQL | 关系型数据,强一致性 |
| 文档/半结构化 | 大 | MongoDB | JSON、文档型数据 |
| 历史归档/宽表 | 超大 | HBase | 适合大数据量、低频访问 |
| 检索/日志 | 大 | Elasticsearch | 支持全文检索、聚合分析 |
| 文件/图片/视频 | 大 | OSS/S3/MinIO | 专业对象存储,支持大文件 |
API接口手册表格
| 方法名 | 参数 | 返回值 | 适用场景 | 是否推荐toC | 注意事项 | 错误用法隐患 | 正确用法建议 |
|---|---|---|---|---|---|---|---|
| addIntCache | key, value[, timeout] | void | 计数、状态 | 是 | 不设置timeout慎用 | 永久缓存导致内存泄漏 | 建议设置过期时间 |
| addLongCache | key, value[, timeout] | void | 计数、状态 | 是 | 同上 | 同上 | 同上 |
| addFloatCache | key, value[, timeout] | void | 计数、状态 | 是 | 同上 | 同上 | 同上 |
| addDoubleCache | key, value[, timeout] | void | 计数、状态 | 是 | 同上 | 同上 | 同上 |
| addBooleanCache | key, value[, timeout] | void | 状态标记 | 是 | 同上 | 同上 | 同上 |
| addStringCache | key, value[, timeout] | void | 小型KV缓存 | 是 | 不要存大对象 | 内存膨胀、雪崩 | 只存小对象,设置过期 |
| addObjectToHash | key, value[, timeout] | void | 对象缓存 | 否 | 不要存大对象 | 内存膨胀 | 用MongoDB等NoSQL |
| addListCache | key, List, timeout | void | 小型列表缓存 | 有条件 | 不要存大对象/大集合 | 内存膨胀、主从阻塞 | 只存小集合,控制长度 |
| addSetCache | key, Set, timeout | void | 小型集合缓存 | 有条件 | 不要存大对象/大集合 | 同上 | 同上 |
| addCache2Hash | key, hashKey, hashValue | void | Hash结构 | 有条件 | 不要大对象 | 同上 | 同上 |
| addCacheAllHash | key, Map, timeout | void | Hash结构 | 有条件 | 不要大对象 | 同上 | 同上 |
| addListItem | key, value | void | 列表追加 | 有条件 | 不要大对象 | 同上 | 同上 |
| addSetItem | key, value | void | 集合追加 | 有条件 | 不要大对象 | 同上 | 同上 |
| getIntCache | key | Integer | 读取计数 | 是 | - | - | - |
| getLongCache | key | Long | 读取计数 | 是 | - | - | - |
| getFloatCache | key | Float | 读取计数 | 是 | - | - | - |
| getDoubleCache | key | Double | 读取计数 | 是 | - | - | - |
| getBooleanCache | key | Boolean | 读取状态 | 是 | - | - | - |
| getStringCache | key | String | 读取小型KV | 是 | - | - | - |
| getObjectFromHash | key, Class | T | 读取对象 | 否 | 不要大对象 | 内存膨胀 | 用NoSQL |
| getListCache | key, Class | List<T> | 读取列表 | 有条件 | 不要大对象/大集合 | 内存膨胀 | 只存小集合 |
| getSetCache | key, Class | Set<T> | 读取集合 | 有条件 | 不要大对象/大集合 | 同上 | 同上 |
| getHashCache | key, Class | Map<String,T> | 读取Hash | 有条件 | 不要大对象/大集合 | 同上 | 同上 |
| removeCache | key/keys | void | 主动失效 | 是 | - | - | - |
| removeHashItem | key, hashKey... | void | Hash失效 | 是 | - | - | - |
| removeListItem | key, value, count | void | 列表移除 | 是 | - | - | - |
| removeSetItem | key, values... | void | 集合移除 | 是 | - | - | - |
| increment | key[, delta, timeout] | long/double | 计数器 | 是 | - | - | - |
| decrement | key[, delta, timeout] | long | 计数器 | 是 | - | - | - |
| setExpiredTime | key, timeout | void | 设置过期 | 是 | 必须设置 | 不设置导致内存泄漏 | 必须设置过期时间 |
| hasKey | key | boolean | 判断存在 | 是 | - | - | - |
| optimisticLock | key[, seconds] | CacheLock | 分布式锁 | 是 | 锁粒度、超时要合理 | 死锁 | 合理设计锁粒度/超时 |
| pessimisticLock | key[, seconds] | CacheLock | 分布式锁 | 是 | 同上 | 同上 | 同上 |
| batchLock | keys, timeout, unit | CacheBatchLock | 批量锁 | 有条件 | 谨慎批量 | 死锁 | 控制粒度 |
| batchAddToList/Set/Hash/String | Map | void | 批量写入 | 否 | 不要大批量操作 | Redis阻塞 | 拆分批量,异步处理 |
| getValueMap | keys, TypeReference | Map | 批量读取 | 否 | 不要大批量 | Redis阻塞 | 拆分批量 |
| getObjects | keys, TypeReference | List | 批量读取 | 否 | 不要大批量 | Redis阻塞 | 拆分批量 |
| getListSize getSetSize getHashSize getZSetSize | key | Long | 获取长度 | 是 | - | - | - |
| leftPushListElement rightPushListElement | key, value | Long | 队列操作 | 是 | - | - | - |
| leftPopListElement rightPopListElement | key, Class | T/List<T> | 队列操作 | 是 | - | - | - |
| getZSetCache | key, start, end, TypeReference | Map<Double,T> | 有序集合 | 有条件 | 不要大对象/大集合 | 内存膨胀 | 只存小集合 |
| addZSet addZSetItem | key, TreeSet/Obj, score | void | 有序集合 | 有条件 | 不要大对象/大集合 | 同上 | 同上 |
| removeZSetItem | key, ... | void | 有序集合移除 | 是 | - | - | - |
| getZSetRank getZSetReverseRank | key, value | Long | 排名 | 是 | - | - | - |
| reverseScoreRangeFromZSet | key, start/end/min/max, TypeReference | Set<T> | 区间查询 | 有条件 | 不要大对象/大集合 | 同上 | 同上 |
| publishNotification | topic, message | Long | 发布订阅 | 有条件 | - | - | - |
| produceMessages consumeMessages | streamKey, ... | String/List<StreamMessage> | Stream消息 | 有条件 | - | - | - |
| getKeyType getValueType | key | KeyTypeEnum/Class | 类型判断 | 是 | - | - | - |
| persist expireAt | key, date | boolean | 过期控制 | 是 | - | - | - |
| dump | key | byte[] | 序列化 | 有条件 | - | - | - |
| copy move rename renameIfAbsent | ... | boolean/void | Key管理 | 有条件 | - | - | - |
| pfAdd pfCount | key, values | void/long | HyperLogLog | 有条件 | - | - | - |
| setBit getBit | key, offset, value | void/boolean | 位图 | 有条件 | - | - | - |
| evalLua | script, keys, args, Class | T | Lua脚本 | 有条件 | - | - | - |
| tryAcquire | key, maxCount, windowSeconds | boolean | 限流 | 是 | - | - | - |
| geoDist geoRadius | key, ... | Distance/List<GeoPointResult> | 地理位置 | 有条件 | - | - | - |
本地缓存组件作用
本地缓存组件是对缓存技术的封装,并屏蔽了具体缓存中间件对业务代码的影响。目前支持了基于JSR 107标准的缓存中间件:Caffeine(4.2.0版提供)、Ehcache,使用进程级缓存需要注意的是,进程级缓存对JVM内存的使用是有一定的影响的,所以在使用时需要根据实际业务情况对缓存的大小进行调整,以避免因为缓存过大导致JVM内存溢出的情况,这一点非常重要,我们通常只会将一些关键且核心的只读数据往内存缓存中存放,而对于一些大数据量的缓存,我们通常会选择使用Redis等分布式缓存中间件进行集中管理,以提升缓存的效率和稳定性。
本地缓存组件用法
本地缓存和Redis缓存一样,提供了一个LocalCache的静态工具类,方便使用者在业务代码中直接调用,而无需关心本地缓存技术的具体实现,以达到简化开发、屏蔽实现细节和目标组件解耦的目的。
本地缓存的存储原理和结构如下图所示
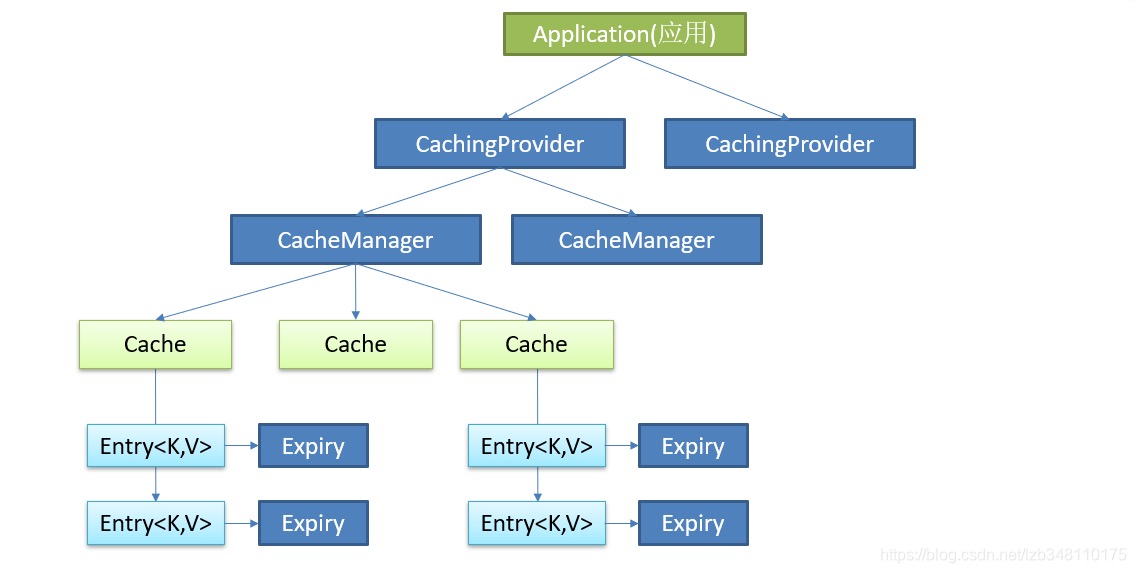
LocalCache对本地缓存使用的常见方法进行了封装,使用者可以直接调用LocalCache的方法来操作本地缓存,如下所示:
示例:
// 存储访问日志信息到logCache日志分区中
LocalCache.put("logCache", accessLogInfo.getId().toString(), accessLogInfo);
// 从logCache日志分区中获取访问日志信息
LocalCache.get("logCache", accessLogInfo.getId().toString());
// 从本地缓存中弹出指定数量的数据
Map<String, AccessLogInfo> accessLogMap = LocalCache.popByCount("access_log", properties.getDbBatchSize());
......
LocalCache的API文档请参考下面的Javadoc。
- Javadoc: 查看LocalCache API
Redis消息队列的使用
该功能自4.3.0版本开始可用
和其他队列的区别
Redis的消息队列功能不是为替代RabbitMQ、RocketMQ或Kafka的,其有适用于自己的特定场景,其更适合轻量级业务场景使用,比如:
- 轻量级应用:对于小型项目或简单的消息传递需求,Redis 提供了一个快速而简单的解决方案。
- 低延迟要求:当需要极低延迟的消息传递时,Redis 的内存存储特性可以提供高速的消息处理能力。
- 简单的消息模型:如果只需要基本的点对点或发布/订阅模型,Redis 的列表和频道功能足够使用。
- 实时应用:实时应用程序,例如在线游戏、聊天应用或实时数据分析,可以从 Redis 的高性能中受益。
- 简单的任务队列:对于简单的后台任务处理,如文件上传、邮件发送等,Redis 可以作为一个快速的任务队列。
- 状态跟踪:Redis 可以用来跟踪任务的状态,比如一个任务是否被处理过或者是否成功完成。
Redis队列的优点
- 高性能:Redis 是基于内存的操作,因此具有非常高地读写速度。
- 简单易用:Redis 的 API 和命令集相对简单,易于理解和使用。
- 灵活性:支持多种数据结构,如列表、集合、哈希表等,可以适应不同的消息队列需求。
- 可靠性:Redis 支持数据持久化,可以通过 RDB 或 AOF 方式保证数据不丢失。
- 轻量级:相对于专门的消息队列系统,Redis 的部署和维护成本较低。
- 集成方便:Redis 拥有丰富的客户端库,支持多种编程语言,便于集成到现有的系统中。
Redis队列的缺点
- Redis消息队列不适合处理大规模消息流或需要复杂消息路由的情况
- 对于需要高可用性、水平扩展性、消息持久性和复杂消息处理逻辑的应用,更专业的消息队列系统可能是更好的选择。
总的来说,Redis 作为消息队列在一些特定的场景下是非常有用的,特别是在那些对性能要求较高而对消息处理的复杂度要求较低的情况下。我们可以优先选择Redis作为消息队列。
Redis队列的使用
Redis队列和其他的消息队列中间件类似,有2个重要的对象,分别是:消息主题的发布者、消息主题的订阅者。
发布者即下发消息的一方,仅需要调用GlobalCache中提供的publish方法即可。而消费者使用略微复杂,需要先实现一个消息订阅者的实现类,然后将该订阅者通过配置文件的方式注册到服务中,以便在收到消息的时候可以通知给对应主题的订阅者。
那么,下面我们就看一下具体的使用方式
/* 消息发布者 */
package cn.com.rydeen.component.template.redis.controller;

import cn.com.rydeen.base.common.api.vo.ResultVO;
import cn.com.rydeen.component.cache.redis.manage.GlobalCache;
import org.springframework.web.bind.annotation.PostMapping;
import org.springframework.web.bind.annotation.RequestBody;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
@RequestMapping("/redis/queue")
public class RedisQueueController {

    public record MessageData(String topic, Object message) {
    }

    @PostMapping("/send")
    public ResultVO<?> send(@RequestBody MessageData data) {
        // 发送消息(需要:topic主题名称和消息体内容)
        Long count = GlobalCache.publish(data.topic, data.message);
        return ResultVO.getSuccess(count);
    }
}
/* 消息订阅者 */
package cn.com.rydeen.component.template.redis.subscriber;

import cn.com.rydeen.component.cache.redis.manage.queue.MessageSubscriber;
import cn.com.rydeen.component.template.redis.domain.UserInfo;
import lombok.extern.slf4j.Slf4j;
import org.jetbrains.annotations.NotNull;

@Slf4j
public class UserMessageSubscriber extends MessageSubscriber<UserInfo> {


    @Override
    protected Class<UserInfo> getValueType() {
        return UserInfo.class;
    }

    @Override
    protected void handleMessage(@NotNull UserInfo userInfo, byte[] pattern) {
        log.info("Received user message: {}", userInfo);
    }

}
/* 消息实体信息 */
package cn.com.rydeen.component.template.redis.domain;

import lombok.Data;

import java.io.Serializable;

@Data
public class UserInfo implements Serializable {

    private String name;

    private Integer age;

    private String slogan;
}
# application.yml 注册消费者的配置
spring:
  data:
    # Redis连接配置
    redis:
      server-type: standalone
      client-name: platform-redis
      client-type: lettuce
      host: 10.100.0.87
      port: 6379
      password: 123456
      database: 15
      timeout: 2000
      connect-timeout: 5000
      queue:
        # 注册的主题消费者队列
        topics:
              # 此处的name,就是消息发布的时候使用的topic的名字
          -   name: 'topic-user'
              # 精确主题订阅
              type: channel
              # 当前主题对应的订阅者
              subscriber: cn.com.rydeen.component.template.redis.subscriber.UserMessageSubscriber
              # 统配方式匹配的多个topic队列名称
          -   name: 'topic-order*'
              # 通配主题订阅
              type: pattern
              # 当前多个主题对应的唯一订阅者
              subscriber: cn.com.rydeen.component.template.redis.subscriber.GeneralMessageSubscriber
      # 其他配置省略
至此,我们就完成了队列使用的全部代码,在代码中,我们建议将topic名称字符串通过枚举或常量的方式进行维护,不要在代码中增加魔法值。
在上方的配置文件中topic对应的type是一个枚举值,其对应的定义内容如下:
package cn.com.rydeen.component.cache.redis.enums;

/**
 * 主题类型
 *
 * @author richie696
 * @version 1.0
 * @since 2024-08-12 22:50:06
 */
public enum TopicTypeEnum {
    /**
     * <p>1vs1主题
     * <ul>
     *     <li>用于精确订阅特定的频道</li>
     *     <li>只能订阅一个具体的频道</li>
     *     <li>适用于只需要订阅单个频道的场景</li>
     * </ul>
     */
    CHANNEL,
    /**
     * <p>1vsN主题
     * <ul>
     *     <li>用于基于模式的订阅</li>
     *     <li>允许使用通配符(如:*)来匹配多个频道的场景</li>
     *     <li>适用于需要订阅一组相关频道的场景</li>
     * </ul>
     */
    PATTERN
}