Java 20 新特性 (EOL)
官方发布介绍页面:https://openjdk.org/projects/jdk/20/
生命周期结束时间(EOL): 2023/09/21
1. 作用域值 (第一次孵化)
Scoped Values 提供了一种在特定范围内共享数据的方式,类似于线程本地变量。
import jdk.incubator.concurrent.ScopedValue;

public class ScopedValuesExample {
    private static final ScopedValue<String> SCOPED_VALUE = ScopedValue.newInstance();

    public static void main(String[] args) {
        ScopedValue.where(SCOPED_VALUE, "Hello, Scoped Value!")
                   .run(() -> System.out.println(SCOPED_VALUE.get()));
    }
}
2. 记录模式(第二次预览)
记录模式 (Record Patterns) 可对 record 的值进行解构,也就是更方便地从记录类(Record Class)中提取数据。并且,还可以嵌套记录模式和类型模式结合使用,以实现强大的、声明性的和可组合的数据导航和处理形式。
记录模式不能单独使用,而是要与 instanceof 或 switch 模式匹配一同使用。 案例一:
record Shape(String type, long unit){}
没有记录模式之前:
Shape circle = new Shape("Circle", 10);
if (circle instanceof Shape shape) {
  System.out.println("Area of " + shape.type() + " is : " + Math.PI * Math.pow(shape.unit(), 2));
}
有了记录模式之后:
Shape circle = new Shape("Circle", 10);
if (circle instanceof Shape(String type, long unit)) {
  System.out.println("Area of " + type + " is : " + Math.PI * Math.pow(unit, 2));
}
案例二:
interface Shape {}
record Circle(double radius) implements Shape { }
record Square(double side) implements Shape { }
record Rectangle(double length, double width) implements Shape { }
没有记录模式之前:
Shape shape = new Circle(10);
switch (shape) {
    case Circle c:
        System.out.println("The shape is Circle with area: " + Math.PI * c.radius() * c.radius());
        break;

    case Square s:
        System.out.println("The shape is Square with area: " + s.side() * s.side());
        break;

    case Rectangle r:
        System.out.println("The shape is Rectangle with area: + " + r.length() * r.width());
        break;

    default:
        System.out.println("Unknown Shape");
        break;
}
有了记录模式之后:
Shape shape = new Circle(10);
switch(shape) {

  case Circle(double radius):
    System.out.println("The shape is Circle with area: " + Math.PI * radius * radius);
    break;

  case Square(double side):
    System.out.println("The shape is Square with area: " + side * side);
    break;

  case Rectangle(double length, double width):
    System.out.println("The shape is Rectangle with area: + " + length * width);
    break;

  default:
    System.out.println("Unknown Shape");
    break;
}
记录模式可以避免不必要的转换,使得代码更建简洁易读。而且,用了记录模式后不必再担心 null 或者 NullPointerException,代码更安全可靠。
3. switch支持模式匹配 (第四次预览)
switch 语句中的模式匹配进一步增强。
public class PatternMatchingSwitchExample {
    public static void main(String[] args) {
        System.out.println(formatterPatternSwitch(123));
        System.out.println(formatterPatternSwitch("Hello"));
    }

    static String formatterPatternSwitch(Object obj) {
        return switch (obj) {
            case Integer i -> String.format("int %d", i);
            case Long l    -> String.format("long %d", l);
            case Double d  -> String.format("double %f", d);
            case String s  -> String.format("String %s", s);
            default        -> obj.toString();
        };
    }
}
4. 外部函数和内存API (第二次预览)
外部函数和内存 API 允许 Java 程序调用本地代码和访问外部内存。
import jdk.incubator.foreign.*;

public class ForeignFunctionMemoryExample {
    public static void main(String[] args) {
        try (MemorySegment segment = MemorySegment.allocateNative(100)) {
            MemoryAccess.setIntAtOffset(segment, 0, 42);
            int value = MemoryAccess.getIntAtOffset(segment, 0);
            System.out.println(value); // 42
        }
    }
}
5. 虚拟线程 (第二次预览)
虚拟线程(Virtual Thread)是 JDK 而不是 OS 实现的轻量级线程(Lightweight Process,LWP),由 JVM 调度。许多虚拟线程共享同一个操作系统线程,虚拟线程的数量可以远大于操作系统线程的数量。
在引入虚拟线程之前,java.lang.Thread 包已经支持所谓的平台线程,也就是没有虚拟线程之前,我们一直使用的线程。JVM 调度程序通过平台线程(载体线程)来管理虚拟线程,一个平台线程可以在不同的时间执行不同的虚拟线程(多个虚拟线程挂载在一个平台线程上),当虚拟线程被阻塞或等待时,平台线程可以切换到执行另一个虚拟线程。
虚拟线程、平台线程和系统内核线程的关系图如下所示:
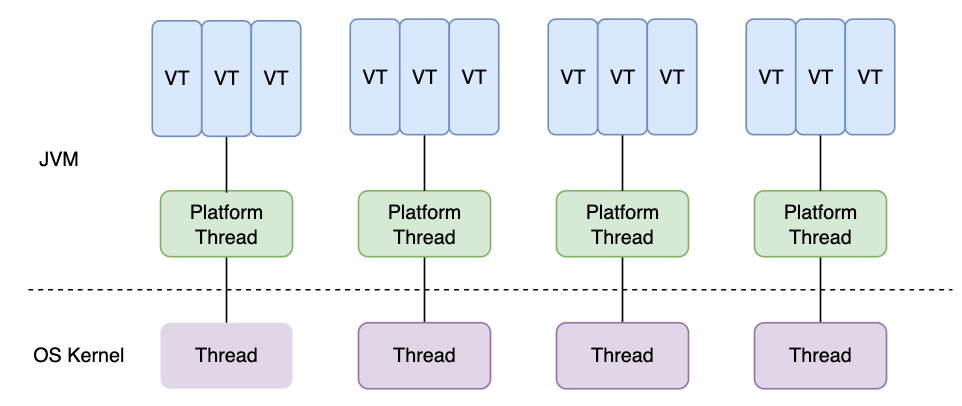
关于平台线程和系统内核线程的对应关系多提一点:在 Windows 和 Linux 等主流操作系统中,Java 线程采用的是一对一的线程模型,也就是一个平台线程对应一个系统内核线程。Solaris 系统是一个特例,HotSpot VM 在 Solaris 上支持多对多和一对一。
相比较于平台线程来说,虚拟线程是廉价且轻量级的,使用完后立即被销毁,因此它们不需要被重用或池化,每个任务可以有自己专属的虚拟线程来运行。虚拟线程暂停和恢复来实现线程之间的切换,避免了上下文切换的额外耗费,兼顾了多线程的优点,简化了高并发程序的复杂,可以有效减少编写、维护和观察高吞吐量并发应用程序的工作量。
虚拟线程在其他多线程语言中已经被证实是十分有用的,比如 Go 中的 Goroutine、Erlang 中的进程。
6. 结构化并发 (第二次孵化器)
Java 19 引入了结构化并发 (Structured Concurrency),一种多线程编程方法,目的是为了通过结构化并发 API 来简化多线程编程,并不是为了取代java.util.concurrent,目前处于孵化器阶段。
结构化并发将不同线程中运行的多个任务视为单个工作单元,从而简化错误处理、提高可靠性并增强可观察性。也就是说,结构化并发保留了单线程代码的可读性、可维护性和可观察性。
结构化并发的基本 API 是StructuredTaskScope。StructuredTaskScope 支持将任务拆分为多个并发子任务,在它们自己的线程中执行,并且子任务必须在主任务继续之前完成。
StructuredTaskScope 的基本用法如下:
import java.util.concurrent.*;

public class StructuredConcurrencyExample {
    public static void main(String[] args) throws InterruptedException, ExecutionException {
        try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
            Future<String> future1 = scope.fork(() -> "Task 1");
            Future<String> future2 = scope.fork(() -> "Task 2");
            scope.join();
            scope.throwIfFailed();
            System.out.println(future1.resultNow());
            System.out.println(future2.resultNow());
        }
    }
}
结构化并发非常适合虚拟线程,虚拟线程是 JDK 实现的轻量级线程。许多虚拟线程共享同一个操作系统线程,从而允许非常多的虚拟线程。
JDK 20 中对结构化并发唯一变化是更新为支持在任务范围内创建的线程StructuredTaskScope继承范围值 这简化了跨线程共享不可变数据,
7. Vector API (第五次孵化器)
Vector API 允许在 Java 中进行矢量计算。
import jdk.incubator.vector.*;

public class VectorExample {
    public static void main(String[] args) {
        VectorSpecies<Integer> SPECIES = IntVector.SPECIES_256;
        int[] a = {1, 2, 3, 4, 5, 6, 7, 8};
        IntVector va = IntVector.fromArray(SPECIES, a, 0);
        IntVector vb = va.add(1);
        vb.intoArray(a, 0);
        for (int i : a) {
            System.out.println(i); // 2, 3, 4, 5, 6, 7, 8, 9
        }
    }
}