Java 21 新特性 (LTS)
官方发布介绍页面:https://openjdk.org/projects/jdk/21/
1. 字符串模板 (预览)
String Templates(字符串模板) 目前仍然是 JDK 21 中的一个预览功能。
String Templates 提供了一种更简洁、更直观的方式来动态构建字符串。通过使用占位符$,我们可以将变量的值直接嵌入到字符串中,而不需要手动处理。在运行时,Java 编译器会将这些占位符替换为实际的变量值。并且,表达式支持局部变量、静态/非静态字段甚至方法、计算结果等特性。
该特性处理字符串的新方法称为:Template Expressions,即:模版表达式。它是 Java 中的一种新型表达式,不仅可以执行字符串插值,还可以编程,从而帮助开发人员安全高效地组成字符串。此外,模板表达式并不局限于组成字符串——它们可以根据特定领域的规则将结构化文本转化为任何类型的对象。
该特性主要目的是为了提高在处理包含多个变量和复杂格式化要求的字符串时的可读性和编写效率。
它的设计目标是:
- 通过简单的方式表达混合变量的字符串,简化 Java 程序的编写。
- 提高混合文本和表达式的可读性,无论文本是在单行源代码中(如字符串字面量)还是跨越多行源代码(如文本块)。
- 通过支持对模板及其嵌入式表达式的值进行验证和转换,提高根据用户提供的值组成字符串并将其传递给其他系统(如构建数据库查询)的 Java 程序的安全性。
- 允许 Java 库定义字符串模板中使用的格式化语法(java.util.Formatter ),从而保持灵活性。
- 简化接受以非 Java 语言编写的字符串(如 SQL、XML 和 JSON)的 API 的使用。
- 支持创建由字面文本和嵌入式表达式计算得出的非字符串值,而无需通过中间字符串表示。
Java 在没有 String Templates 之前,我们通常使用字符串拼接或格式化方法来构建字符串:
//concatenation
message = "Greetings " + name + "!";

//String.format()
message = String.format("Greetings %s!", name);  //concatenation

//MessageFormat
message = new MessageFormat("Greetings {0}!").format(name);

//StringBuilder
message = new StringBuilder().append("Greetings ").append(name).append("!").toString();
有String Templates 后
//concatenation
message = STR."Greetings \{name}!";
Java 目前支持三种模板处理器:
-
STR:自动执行字符串插值,即将模板中的每个嵌入式表达式替换为其值(转换为字符串)。
-
FMT:和 STR 类似,但是它还可以接受格式说明符,这些格式说明符出现在嵌入式表达式的左边,用来控制输出的样式
-
RAW:不会像 STR 和 FMT 模板处理器那样自动处理字符串模板,而是返回一个 StringTemplate 对象,这个对象包含了模板中的文本和表达式的信息
-
除了 JDK 自带的三种模板处理器外,你还可以实现 StringTemplate.Processor 接口来创建自己的模板处理器。
STR 模板处理器
STR 是 Java 平台定义的一种模板处理器。它通过用表达式的值替换模板中的每个嵌入表达式来执行字符串插值。使用 STR 的模板表达式的求值结果是一个字符串。
STR 是一个公共静态 final 字段,会自动导入到每个 Java 源文件中。
@Test
public void STRTest() {
    String sk = "Java 新特性";
    String str1 = STR."\{sk},字符串模板";
    System.out.println(str1);
}
上面的 STR."{sk},字符串模板" 就是一个模板表达式,它主要包含了三个部分:
模版处理器:STR 包含内嵌表达式({blog})的模版 通过.把前面两部分组合起来,形式如同方法调用 当模版表达式运行的时候,模版处理器会将模版内容与内嵌表达式的值组合起来,生成结果。
这个例子只是 STR模版处理器一个很简单的功能,它可以做的事情有很多。
-
数学运算 比如上面的 x + y = ?:
@Testpublic void STRTest() {int x = 1,y =2;String str = STR."\{x} + \{y} = \{x + y}";System.out.println(str);} -
调用方法 STR模版处理器还可以调用方法,比如:
@Testpublic void STRTest() {String str = STR."Hello, \{LoginUserContext.getContext().getUsername()}!";System.out.println(str);} -
访问成员变量 STR模版处理器还可以访问成员变量,比如:
public record User(String name,Integer age) {}@Testpublic void STRTest() {User user = new User("小强", 18);String str = STR."\{user.name()}今年\{user.age()}";System.out.println(str);} -
提醒 需要注意的是,字符串模板表达式中的嵌入表达式数量没有限制,它从左到右依次求值,就像方法调用表达式中的参数一样。例如:
@Testpublic void STRTest() {int i = 0;String str = STR."\{i++},\{i++},\{i++},\{i++},\{i++}";System.out.println(str);}// 结果......// 0,1,2,3,4同时,表达式中也可以嵌入表达式:
@Testpublic void STRTest() {String name = "Oracle";String sk = "Java 新特性";String str = STR."\{name} 的 \{STR."\{sk},字符串模板"}";System.out.println(str);}// 结果......// Oracle 的 Java 新特性,字符串模板但是这种嵌套的方式会比较复杂,容易搞混,一般不推荐。
FMT 模板处理器
FMT 是 Java 定义的另一种模板处理器。它除了与STR模版处理器一样提供插值能力之外,还提供了左侧的格式化处理。下面我们来看看他的功能。比如我们要整理模式匹配的 Switch 表达在 Java 版本中的迭代,也就是下面这个表格
| Java 版本 | 更新类型 | JEP | 更新内容 |
|---|---|---|---|
| Java 17 | 第一次预览 | JEP 406 | 引入模式匹配的 Swith 表达式作为预览特性 |
| Java 18 | 第二次预览 | JEP 420 | 对其做了改进和细微调整 |
| Java 19 | 第三次预览 | JEP 427 | 进一步优化模式匹配的 Swith 表达式 |
| Java 20 | 第四次预览 | JEP 433 | |
| Java 21 | 正式版特性 | JEP 441 | 成为正式特性 |
如果使用 STR 模板处理器,代码如下:
@Test
public void STRTest() {
    SwitchHistory[] switchHistories = new SwitchHistory[]{
            new SwitchHistory("Java 17","第一次预览","JEP 406","引入模式匹配的 Swith 表达式作为预览特性。"),
            new SwitchHistory("Java 18","第二次预览","JEP 420","对其做了改进和细微调整"),
            new SwitchHistory("Java 19","第三次预览","JEP 427","进一步优化模式匹配的 Swith 表达式"),
            new SwitchHistory("Java 20","第四次预览","JEP 433",""),
            new SwitchHistory("Java 21","正式特性","JEP 441","成为正式特性"),
    };

    String history = STR."""
            Java 版本     更新类型    JEP 更新内容
            \{switchHistories[0].javaVersion()} \{switchHistories[0].updateType()} \{switchHistories[0].jep()} \{switchHistories[0].content()}
            \{switchHistories[1].javaVersion()} \{switchHistories[1].updateType()} \{switchHistories[1].jep()} \{switchHistories[1].content()}
            \{switchHistories[2].javaVersion()} \{switchHistories[2].updateType()} \{switchHistories[2].jep()} \{switchHistories[2].content()}
            \{switchHistories[3].javaVersion()} \{switchHistories[3].updateType()} \{switchHistories[3].jep()} \{switchHistories[3].content()}
            \{switchHistories[4].javaVersion()} \{switchHistories[4].updateType()} \{switchHistories[4].jep()} \{switchHistories[4].content()}
            """;
    System.out.println(history);
}
得到的效果是这样的:
Java 版本     更新类型    JEP 更新内容
Java 17 第一次预览 JEP 406 引入模式匹配的 Swith 表达式作为预览特性。
Java 18 第二次预览 JEP 420 对其做了改进和细微调整
Java 19 第三次预览 JEP 427 进一步优化模式匹配的 Swith 表达式
Java 20 第四次预览 JEP 433
Java 21 正式特性 JEP 441 成为正式特性
是不是很丑?完全对不齐,没法看。为了解决这个问题,就可以采用FMT模版处理器,在每一列左侧定义格式:
   @Test
    public void STRTest() {
        SwitchHistory[] switchHistories = new SwitchHistory[]{
                new SwitchHistory("Java 17","第一次预览","JEP 406","引入模式匹配的 Swith 表达式作为预览特性。"),
                new SwitchHistory("Java 18","第二次预览","JEP 420","对其做了改进和细微调整"),
                new SwitchHistory("Java 19","第三次预览","JEP 427","进一步优化模式匹配的 Swith 表达式"),
                new SwitchHistory("Java 20","第四次预览","JEP 433",""),
                new SwitchHistory("Java 21","正式特性","JEP 441","成为正式特性"),
        };

        String history = FMT."""
                Java 版本     更新类型        JEP             更新内容
                %-10s\{switchHistories[0].javaVersion()}  %-9s\{switchHistories[0].updateType()} %-10s\{switchHistories[0].jep()} %-20s\{switchHistories[0].content()}
                %-10s\{switchHistories[1].javaVersion()}  %-9s\{switchHistories[1].updateType()} %-10s\{switchHistories[1].jep()} %-20s\{switchHistories[1].content()}
                %-10s\{switchHistories[2].javaVersion()}  %-9s\{switchHistories[2].updateType()} %-10s\{switchHistories[2].jep()} %-20s\{switchHistories[2].content()}
                %-10s\{switchHistories[3].javaVersion()}  %-9s\{switchHistories[3].updateType()} %-10s\{switchHistories[3].jep()} %-20s\{switchHistories[3].content()}
                %-10s\{switchHistories[4].javaVersion()}  %-9s\{switchHistories[4].updateType()} %-10s\{switchHistories[4].jep()} %-20s\{switchHistories[4].content()}
                """;
        System.out.println(history);
    }
输出如下:
Java 版本     更新类型        JEP             更新内容
Java 17     第一次预览     JEP 406    引入模式匹配的 Swith 表达式作为预览特性。
Java 18     第二次预览     JEP 420    对其做了改进和细微调整
Java 19     第三次预览     JEP 427    进一步优化模式匹配的 Swith 表达式
Java 20     第四次预览     JEP 433
Java 21     正式特性       JEP 441    成为正式特性
2. 有序集合
在 Java 21 之前,访问Java中集合的第一个和最后一个元素的方式:
| 集合  | 获取第一个元素  | 获取最后一个元素  |
|---|---|---|
| List  | list.get(0)  | list.get(list.size() - 1)  |
| Deque  | deque.getFirst()  | deque.getLast()  |
| SortedSet  | sortedSet.first()  | sortedSet.last()  |
三个集合提供了三类不同的使用方法,非常混乱。为了解决这种混乱,Java 21 引入有序集合,旨在解决访问Java中各种集合类型的第一个和最后一个元素需要非统一且麻烦处理场景。
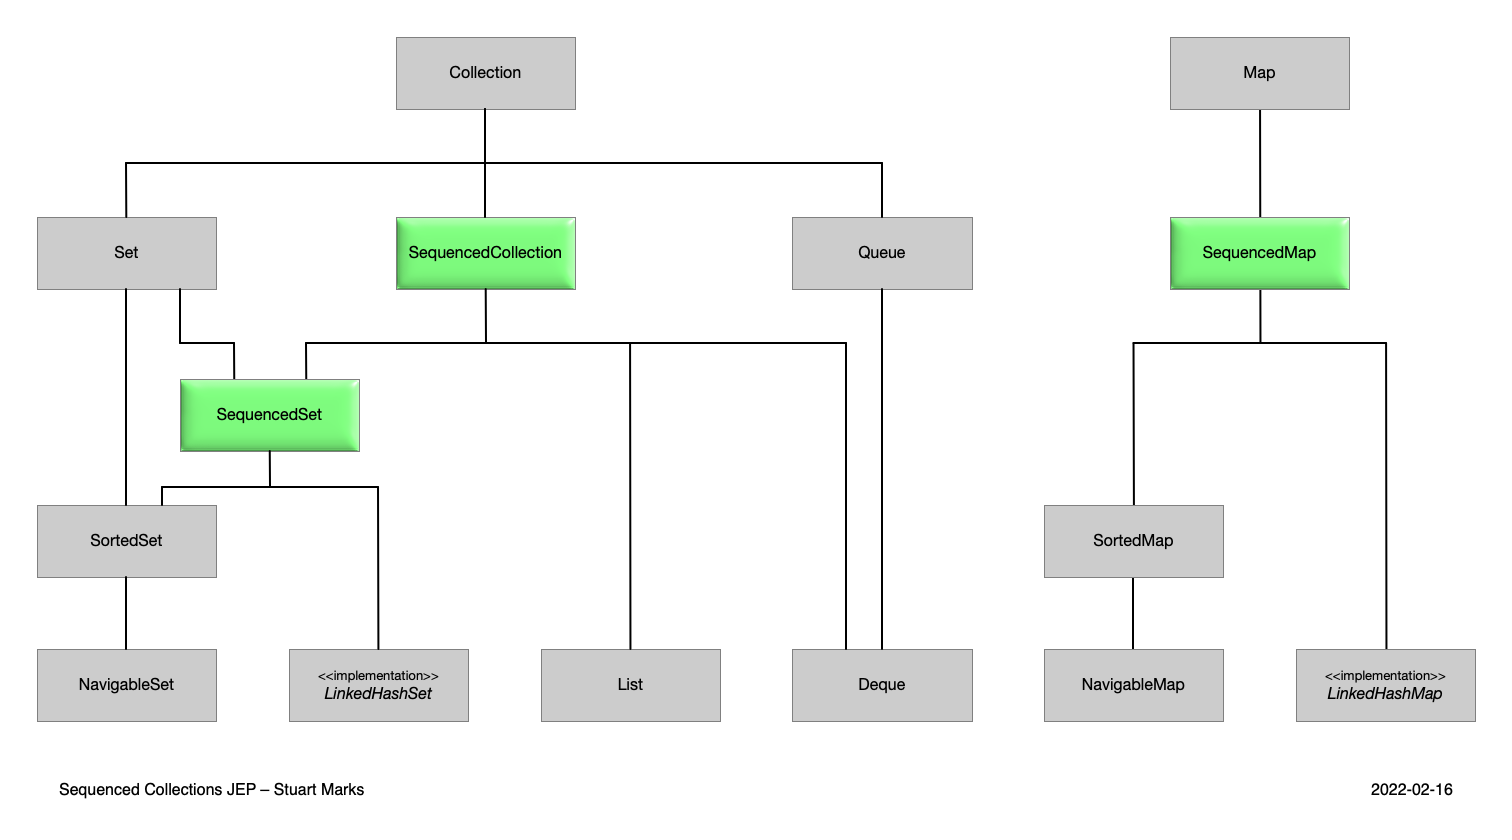
JDK 21 引入了一种新的集合类型:Sequenced Collections(序列化集合,也叫有序集合),这是一种具有确定出现顺序(encounter order)的集合(无论我们遍历这样的集合多少次,元素的出现顺序始终是固定的)。序列化集合提供了处理集合的第一个和最后一个元素以及反向视图(与原始集合相反的顺序)的简单方法。
Sequenced Collections 包括以下三个接口:
- SequencedCollection
- SequencedSet
- SequencedMap
SequencedCollection 接口
SequencedCollection 接口继承了 Collection接口, 提供了在集合两端访问、添加或删除元素以及获取集合的反向视图的方法。
interface SequencedCollection<E> extends Collection<E> {
  // New Method
  SequencedCollection<E> reversed();

  // Promoted methods from Deque<E>

  void addFirst(E);
  void addLast(E);

  E getFirst();
  E getLast();

  E removeFirst();
  E removeLast();
}
List 和 Deque 接口实现了SequencedCollection 接口。
这里以 ArrayList 为例,演示一下实际使用效果:
ArrayList<Integer> arrayList = new ArrayList<>();

arrayList.add(1);   // List contains: [1]

arrayList.addFirst(0);  // List contains: [0, 1]
arrayList.addLast(2);   // List contains: [0, 1, 2]

Integer firstElement = arrayList.getFirst();  // 0
Integer lastElement = arrayList.getLast();  // 2

List<Integer> reversed = arrayList.reversed();
System.out.println(reversed); // Prints [2, 1, 0]
SequencedSet 接口
SequencedSet接口直接继承了 SequencedCollection 接口并重写了 reversed() 方法。
interface SequencedSet<E> extends SequencedCollection<E>, Set<E> {
    SequencedSet<E> reversed();
}
SortedSet 和 LinkedHashSet 实现了SequencedSet接口。
这里以 LinkedHashSet 为例,演示一下实际使用效果:
LinkedHashSet<Integer> linkedHashSet = new LinkedHashSet<>(List.of(1, 2, 3));

Integer firstElement = linkedHashSet.getFirst();   // 1
Integer lastElement = linkedHashSet.getLast();    // 3

linkedHashSet.addFirst(0);  //List contains: [0, 1, 2, 3]
linkedHashSet.addLast(4);   //List contains: [0, 1, 2, 3, 4]

System.out.println(linkedHashSet.reversed());   //Prints [5, 3, 2, 1, 0]
SequencedMap 接口
SequencedMap 接口继承了 Map接口, 提供了在集合两端访问、添加或删除键值对、获取包含 key 的 SequencedSet、包含 value 的 SequencedCollection、包含 entry(键值对) 的 SequencedSet以及获取集合的反向视图的方法。
interface SequencedMap<K,V> extends Map<K,V> {
  // New Methods

  SequencedMap<K,V> reversed();

  SequencedSet<K> sequencedKeySet();
  SequencedCollection<V> sequencedValues();
  SequencedSet<Entry<K,V>> sequencedEntrySet();

  V putFirst(K, V);
  V putLast(K, V);


  // Promoted Methods from NavigableMap<K, V>

  Entry<K, V> firstEntry();
  Entry<K, V> lastEntry();

  Entry<K, V> pollFirstEntry();
  Entry<K, V> pollLastEntry();
}
SortedMap 和LinkedHashMap 实现了SequencedMap 接口。
这里以 LinkedHashMap 为例,演示一下实际使用效果:
LinkedHashMap<Integer, String> map = new LinkedHashMap<>();

map.put(1, "One");
map.put(2, "Two");
map.put(3, "Three");

map.firstEntry();   //1=One
map.lastEntry();    //3=Three

System.out.println(map);  //{1=One, 2=Two, 3=Three}

Map.Entry<Integer, String> first = map.pollFirstEntry();   //1=One
Map.Entry<Integer, String> last = map.pollLastEntry();    //3=Three

System.out.println(map);  //{2=Two}

map.putFirst(1, "One");     //{1=One, 2=Two}
map.putLast(3, "Three");    //{1=One, 2=Two, 3=Three}

System.out.println(map);  //{1=One, 2=Two, 3=Three}
System.out.println(map.reversed());   //{3=Three, 2=Two, 1=One}
3. 分代 ZGC
JDK21 中对 ZGC 进行了功能扩展,增加了分代 GC 功能。不过,默认是关闭的,需要通过配置打开:
// 启用分代ZGC
java -XX:+UseZGC -XX:+ZGenerational ...
在未来的版本中,官方会把 ZGenerational 设为默认值,即默认打开 ZGC 的分代 GC。在更晚的版本中,非分代 ZGC 就被移除。
分代 ZGC 可以显著减少垃圾回收过程中的停顿时间,并提高应用程序的响应性能。这对于大型 Java 应用程序和高并发场景下的性能优化非常有价值。
4. 记录模式
Record Patterns 允许在模式匹配中使用记录类型。
public class RecordPatternsExample {
    record Point(int x, int y) {}

    public static void main(String[] args) {
        Object obj = new Point(1, 2);
        if (obj instanceof Point(int x, int y)) {
            System.out.println("x: " + x + ", y: " + y);
        }
    }
}
5. switch 支持模式匹配
switch 语句中的模式匹配进一步增强。
public class PatternMatchingSwitchExample {
    public static void main(String[] args) {
        System.out.println(formatterPatternSwitch(123));
        System.out.println(formatterPatternSwitch("Hello"));
    }

    static String formatterPatternSwitch(Object obj) {
        return switch (obj) {
            case Integer i -> String.format("int %d", i);
            case Long l    -> String.format("long %d", l);
            case Double d  -> String.format("double %f", d);
            case String s  -> String.format("String %s", s);
            default        -> obj.toString();
        };
    }
}
6. 外部函数和内存API(第三次预览)
外部函数和内存 API (Foreign Function & Memory API) 允许 Java 程序调用本地代码和访问外部内存。提供了一个纯 Java 应用程序接口,用于替代 JNI(Java Native Interface),以支持直接调用本地函数和操作内存。这有助于提高性能和易用性。
import jdk.incubator.foreign.*;

public class ForeignFunctionMemoryExample {
    public static void main(String[] args) {
        try (MemorySegment segment = MemorySegment.allocateNative(100)) {
            MemoryAccess.setIntAtOffset(segment, 0, 42);
            int value = MemoryAccess.getIntAtOffset(segment, 0);
            System.out.println(value); // 42
        }
    }
}
7. 未命名模式和变量(第一次预览)
未命名模式和变量使得我们可以使用下划线 _ 表示未命名的变量以及模式匹配时不使用的组件,旨在提高代码的可读性和可维护性。
未命名变量的典型场景是 try-with-resources 语句、 catch 子句中的异常变量和for循环。当变量不需要使用的时候就可以使用下划线 _ 代替,这样清晰标识未被使用的变量。
try (var _ = ScopedContext.acquire()) {
  // No use of acquired resource
}
try { ... }
catch (Exception _) { ... }
catch (Throwable _) { ... }

for (int i = 0, _ = runOnce(); i < arr.length; i++) {
  ...
}
未命名模式是一个无条件的模式,并不绑定任何值。未命名模式变量出现在类型模式中。
if (r instanceof ColoredPoint(_, Color c)) { ... c ... }

switch (b) {
    case Box(RedBall _), Box(BlueBall _) -> processBox(b);
    case Box(GreenBall _)                -> stopProcessing();
    case Box(_)                          -> pickAnotherBox();
}
8. 虚拟线程
虚拟线程是一项重量级的更新,在 Java 19 中进行了第一次预览,由JEP 425提出。JDK 20 中是第二次预览。最终,虚拟线程在 JDK21 顺利转正。
JVM 是一个多线程环境,它通过 java.lang.Thread 为我们提供了对操作系统线程的抽象,但是 Java 中的线程都只是对操作系统线程的一种简单封装,我们可以称之为“平台线程”。
然后,就平台线程而言,在某些场景下,它是有一些缺陷的,具体体现在:
- 代价昂贵:创建平台线程的成本很高。每当创建一个平台线程时,操作系统都必须在堆栈中分配大量内存来存储线程的上下文、原生调用堆栈和 Java 调用堆栈。由于堆栈大小是固定的,这就导致了高昂的内存开销。
- 上下文切换成本高:在多线程环境下,需要在不同线程间切换,这种上下文切换会消耗时间和资源。
- 线程数量有限:Java 线程仅仅只是对操作系统线程的封装,而操作系统线程的数量是有限的,这就限制了 Java 同时运行的线程数量,从而限制了应用程序的并发能力。
然后虚拟线程就没有这个烦恼。
那什么是虚拟线程呢?
虚拟线程是 Java 中的一种轻量级线程,它旨在解决传统线程模型中的一些限制,提供了更高效的并发处理能力,允许创建数千甚至数万个虚拟线程,而无需占用大量操作系统资源。
虚拟线程是 JDK 而不是 OS 实现的轻量级线程(Lightweight Process,LWP),由 JVM 调度。许多虚拟线程共享同一个操作系统线程,虚拟线程的数量可以远大于操作系统线程的数量。
虚拟线程与传统线程具有如下几个优势:
- 更加轻量级:虚拟线程相比传统线程更加轻量级。因为它们不是直接映射到操作系统线程上,而是在用户空间内被管理。这种设计减少了线程创建和销毁的开销,允许在同一应用中运行成千上万的线程。【虚拟线程(Virtual Thread-)是 JDK 而不是 OS 实现的轻量级线程(Lightweight Process,LWP),许多虚拟线程共享同一个操作系统线程,虚拟线程的数量可以远大于操作系统线程的数量。】
- 资源消耗更少:由于不是直接映射到操作系统线程,虚拟线程显著降低了内存和其他资源的消耗。这使得在有限资源下可以创建更多的线程。
- 上下文切换开销更低:由于虚拟线程在用户空间,而不是通过操作系统,所以它的上下文切换开销更低。
- 改善阻塞操作的处理:在传统线程模型中,阻塞操作(如 I/O)会导致整个线程被阻塞,浪费宝贵的系统资源。然而当一个虚拟线程阻塞时,它可以被挂起,底层的操作系统线程则可以用来运行其他虚拟线程。
- 简化并发编程:可以像编写普通顺序代码一样编写并发代码,而不需要过多考虑线程管理和调度。它简化了 Java 的并发编程模型。
- 提升性能:在 I/O 密集型应用中,虚拟线程能够显著地提升性能。而且由于它们的创建和销毁成本低,能够更加高效地利用系统资源。
虽然虚拟线程这么厉害,但是它不做以下几件事:
- 不替代传统线程:虚拟线程并不旨在完全替代传统的操作系统线程,而是作为一个补充。对于需要密集计算和精细控制线程行为的场景,传统线程仍然是主流。
- 非针对最低延迟:虚拟线程主要针对高并发和高吞吐量,而不是最低延迟。对于需要极低延迟的应用,传统线程可能是更好的选择。
- 不改变基本的线程模型:虚拟线程改进了线程的实现方式,但并未改变Java基本的线程模型和同步机制。锁和同步仍然是并发控制的重要工具。
在引入虚拟线程之前,java.lang.Thread 包已经支持所谓的平台线程(Platform Thread),也就是没有虚拟线程之前,我们一直使用的线程。JVM
调度程序通过平台线程(载体线程)来管理虚拟线程,一个平台线程可以在不同的时间执行不同的虚拟线程(多个虚拟线程挂载在一个平台线程上),当虚拟线程被阻塞或等待时,平台线程可以切换到执行另一个虚拟线程。虚拟线程、平台线程和系统内核线程的关系图如下所示:
如何使用虚拟线程
虚拟线程的使用和普通线程几乎一模一样,他们唯一区别在于创建虚拟线程只能通过特定的方法。
-
Thread.startVirtualThread() 创建 创建虚拟线程最简单的方式就是使用 Thread.startVirtualThread(Runnable),startVirtualThread() 是 Thread 静态方法,它用于创建一个新的虚拟线程,并立即执行给定的 Runnable 任务。
@Testpublic void virtualThreadTest() {Thread.startVirtualThread(() -> {// 这里放置你的任务代码System.out.println("Java 19 新特性:虚拟线程");});} -
使用 Thread.ofVirtual()创建 Thread.ofVirtual() 是一个流式API,用于构建和配置线程。它提供了设置线程属性(如名称、守护状态、优先级、未捕获异常处理器等)的方法。相比直接使用 Thread 来构建线程,Thread.Builder提供了更多的灵活性和控制力。
使用ofVirtual() 可以创建一个虚拟线程:
@Testpublic void virtualThreadTest() {Thread.ofVirtual().name("virtualThreadTest").uncaughtExceptionHandler((t,e)-> System.out.println("线程[" + t.getName() + "发生了异常。message:" + e.getMessage())).start(()->{System.out.println("Java 19 新特性:虚拟线程");});}使用 ofVirtual() 创建一个虚拟线程,然后调用 name() 为虚拟线程设置一个名称,uncaughtExceptionHandler() 用来处理线程执行异常。
Thread.ofVirtual() 还支持设置线程其他属性:
- daemon(boolean):设置线程是否为守护线程。
- priority(int):设置线程优先级。
同时,Thread.ofVirtual() 可以用于生成平台线程,使用 ofPlatform() 。
也能创建不启动的:
public class VirtualThreadTest {public static void main(String[] args) {CustomThread customThread = new CustomThread();// 创建不启动Thread unStarted = Thread.ofVirtual().unstarted(customThread);unStarted.start();// 创建直接启动Thread.ofVirtual().start(customThread);}}static class CustomThread implements Runnable {@Overridepublic void run() {System.out.println("CustomThread run");}} - daemon(boolean):设置线程是否为守护线程。
-
使用 ThreadFactory 创建
public class VirtualThreadTest {public static void main(String[] args) {CustomThread customThread = new CustomThread();ThreadFactory factory = Thread.ofVirtual().factory();Thread thread = factory.newThread(customThread);thread.start();}}static class CustomThread implements Runnable {@Overridepublic void run() {System.out.println("CustomThread run");}} -
使用 Executors.newVirtualThreadPerTaskExecutor()创建 与平台线程异常,虚拟线程也支持线程池,我们可以使用Executors.newVirtualThreadPerTaskExecutor() 创建一个线程池,该线程池会给每个任务分配一个虚拟线程。这意味着每个提交给线程池的任务都会在自己的虚拟线程上异步执行。
ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor();一旦我们创建了虚拟线程池就可以向其提交任务,任务可以是Runnable 或 Callable。
executor.submit(() -> {System.out.println("Java 19 新特性:虚拟线程");});// orFuture<String> future = executor.submit(() -> {return "Java 19 新特性:虚拟线程";});使用完线程池后,我们可以使用shutdown() 来关闭线程池,它会等待正在执行的任务完成,但不会接受新的任务。如果需要立即停止所有任务,可以使用 shutdownNow()。
executor.shutdown();对于虚拟线程而言,虚拟线程池不一定是必须的,如果任务生命周期简单,不需要复杂的管理,并行任务也不是特别多,其实没有必要使用虚拟线程池,直接使用 Thread.startVirtualThread 或 Thread.ofVirtual().start() 来创建和启动虚拟线程可能还更加简单些。
使用场景&注意情况
- 虚拟线程是一种轻量级的线程,它适用于 I/O 密集型的任务。对于CPU密集型任务(如大量计算),平台线程可能是更好的选择,因为虚拟线程在这种情况下可能不会带来性能上面的优势。
- 虽然虚拟线程在资源的消耗上面比平台线程少,但是我们仍然需要合理管理,不要以为资源少就可以随便创建虚拟线程。创建过多的虚拟线程可能会导致内存消耗的增加,尤其是当每个线程都需要维护自己的栈空间时。
- 虚拟线程可能会使得调试和性能监控更加复杂。确保有适当的工具和策略来监控虚拟线程的行为和性能。
9. 未命名类和main方法(第一次预览)
这个特性主要简化了 main 方法的的声明。对于 Java 初学者来说,这个 main 方法的声明引入了太多的 Java 语法概念,不利于初学者快速上手。
没有使用该特性之前定义一个 main 方法:
public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello, World!");
    }
}
使用该新特性之后定义一个 main 方法:
class HelloWorld {
    void main() {
        System.out.println("Hello, World!");
    }
}
进一步精简(未命名的类允许我们不定义类名):
void main() {
   System.out.println("Hello, World!");
}
10. 作用域值(第一次预览)
作用域值(Scoped Values)它可以在线程内和线程间共享不可变的数据,优于线程局部变量,尤其是在使用大量虚拟线程时。
final static ScopedValue<...> V = new ScopedValue<>();

// In some method
ScopedValue.where(V, <value>)
           .run(() -> { ... V.get() ... call methods ... });

// In a method called directly or indirectly from the lambda expression
... V.get() ...
import jdk.incubator.concurrent.ScopedValue;

public class ScopedValuesExample {
    private static final ScopedValue<String> SCOPED_VALUE = ScopedValue.newInstance();

    public static void main(String[] args) {
        ScopedValue.where(SCOPED_VALUE, "Hello, Scoped Value!")
                   .run(() -> System.out.println(SCOPED_VALUE.get()));
    }
}
作用域值允许在大型程序中的组件之间安全有效地共享数据,而无需求助于方法参数。
11. Vector API
Vector API 允许在 Java 中进行矢量计算。
import jdk.incubator.vector.*;

public class VectorExample {
    public static void main(String[] args) {
        VectorSpecies<Integer> SPECIES = IntVector.SPECIES_256;
        int[] a = {1, 2, 3, 4, 5, 6, 7, 8};
        IntVector va = IntVector.fromArray(SPECIES, a, 0);
        IntVector vb = va.add(1);
        vb.intoArray(a, 0);
        for (int i : a) {
            System.out.println(i); // 2, 3, 4, 5, 6, 7, 8, 9
        }
    }
}
12. 弃用 Windows 32 位 x86 端口
终止对 32 位版本的支持
13. 准备禁止动态加载代理
在Java21中将代理动态加载到正在运行的JVM中时发出警告。
这些警告旨在让用户为将来的版本做好准备,该版本默认情况下不允许动态加载代理,以提高默认情况下的完整性。在启动时加载代理的可服务性工具不会导致在任何版本中发出警告。
-
什么是动态加载代理禁用准备?
动态加载代理禁用准备(Prepare to Disallow the Dynamic Loading of Agents)是一个Java增强提案,其目标是在JVM中禁止动态加载代理。代理是一种能够修改或监视应用程序行为的机制,它可以通过字节码注入来实现。
-
为什么需要动态加载代理禁用准备?
动态加载代理允许开发人员在运行时修改和监视Java应用程序的行为。虽然这对于调试和性能分析等方面非常有用,但也存在潜在的安全风险。恶意代码可能会利用动态加载代理的功能来执行恶意操作,例如窃取敏感信息、篡改数据等。
因此,为了加强Java应用程序的安全性,限制动态加载代理的使用是很有必要的。
14. 密钥封装机制API安全库
Java21新特性 – 密钥封装机制 API 介绍一种用于密钥封装机制(Key Encapsulation Mechanism,简称KEM)的API,这是一种通过公共加密来保护对称密钥的加密技术。
该提案的一个目标是使应用程序能够使用KEM算法,如RSA密钥封装机制(RSA-KEM)、椭圆曲线集成加密方案(ECIES),以及美国国家标准与技术研究所(NIST)后量子密码学标准化过程的候选算法。
另一个目标是使KEM能够在更高级别的协议(如传输层安全性(TLS))和加密方案(如混合公钥加密(HPKE))中使用。
此外,安全提供商将能够在Java代码或本机代码中实现KEM算法,并包括在RFC 9180中定义的Diffie-Hellman KEM(DHKEM)的实现。
值得注意的是,最初针对 JDK 21 的JEP 404, Generational Shenandoah(实验性)已从 JDK 21 的最终功能集中正式删除。这是由于“审查过程中发现的风险以及缺乏时间”可以执行如此大的代码贡献所需的彻底审查。” Shenandoah 团队决定“尽其所能提供最好的 Generational Shenandoah”,并将寻求以 JDK 22 为目标。
15. 结构化并发 (第一次预览)
Java 19 和 20 孵化了 2 个版本的结构化并发 (Structured Concurrency),是一种多线程编程方法,目的是为了通过结构化并发 API 来简化多线程编程,并不是为了取代java.util.concurrent,目前处于孵化器阶段。
结构化并发将不同线程中运行的多个任务视为单个工作单元,从而简化错误处理、提高可靠性并增强可观察性。也就是说,结构化并发保留了单线程代码的可读性、可维护性和可观察性。
结构化并发的基本 API 是StructuredTaskScope。StructuredTaskScope 支持将任务拆分为多个并发子任务,在它们自己的线程中执行,并且子任务必须在主任务继续之前完成。
StructuredTaskScope 的基本用法如下:
import java.util.concurrent.*;

public class StructuredConcurrencyExample {
    public static void main(String[] args) throws InterruptedException, ExecutionException {
        try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
            Future<String> future1 = scope.fork(() -> "Task 1");
            Future<String> future2 = scope.fork(() -> "Task 2");
            scope.join();
            scope.throwIfFailed();
            System.out.println(future1.resultNow());
            System.out.println(future2.resultNow());
        }
    }
}