润典Java开发手册 v1.0
一、编程规约
(一) 命名风格
-
【强制】代码中的命名均不能以下划线或美元符号开始,也不能以下划线或美元符号结束。
反例:_name / name / $name / name_ / name$ / name
-
【强制】代码中的命名严禁使用拼音与英文混合的方式,更不允许直接使用中文的方式。
说明:正确的英文拼写和语法可以让阅读者易于理解,避免歧义。注意,即使纯拼音命名方式也要避免采用。
正例: youku / Nanjing 等国际通用的名称,可视同英文。
反例:DaZhePromotion [打折] / getPingfenByName() [评分] / int 某变量 = 3
-
【强制】类名使用 UpperCamelCase 风格,但以下情形例外:DO / BO / DTO / VO / AO / PO / UID 等,此类后缀不允许使用一个大写一个小写
正例:MarcoPolo / UserDO / XmlService / TcpUdpDeal / TaPromotion
反例:macroPolo / UserDo / XMLService / TCPUDPDeal / TAPromotion
-
【强制】方法名、参数名、成员变量、局部变量都统一使用 lowerCamelCase 风格,必须遵从驼峰形式。
正例: localValue / getHttpMessage() / inputUserId
-
【强制】常量命名全部大写,单词间用下划线隔开,力求语义表达完整清楚,不要嫌名字长。
正例:MAX_STOCK_COUNT
反例:MAX_COUNT
-
【强制】POJO 类中布尔类型的变量,都不要加 is 前缀,否则部分框架解析会引起序列化错误。反例:定义为基本数据类型 Boolean isDeleted 的属性,它的方法也是 isDeleted(),json解析在反向解析的时候,“误以为”对应的属性名称是 deleted,导致属性获取不到,进而抛出异常。
-
【强制】包名统一使用小写,点分隔符之间有且仅有一个自然语义的英语单词。包名统一使用单数形式,但是类名如果有复数含义,类名可以使用复数形式。
正例:应用工具类包名为 cn.com.rydeen.ai.util、类名为 MessageUtils(此规则参考 spring的框架结构)
-
【强制】杜绝完全不规范的缩写,避免望文不知义。
反例:AbstractClass“缩写”命名成 AbsClass;condition“缩写”命名成 condi,此类随意缩写严重降低了代码的可阅读性。
-
【推荐】为了达到代码自解释的目标,任何自定义编程元素在命名时,使用尽量完整的单词组合来表达其意。
正例:在 JDK 中,表达原子更新的类名为:AtomicReferenceFieldUpdater。
反例:变量 int a 的随意命名方式。
-
【推荐】如果模块、接口、类、方法使用了设计模式,在命名时需体现出具体模式。说明:将设计模式体现在名字中,有利于阅读者快速理解架构设计理念。
正例:
public class OrderFactory;
public class LoginProxy;
public class ResourceObserver;
- 【推荐】接口类中的方法和属性不要加任何修饰符号(public 也不要加),保持代码的简洁性,并加上有效的 Javadoc 注释。尽量不要在接口里定义变量,如果一定要定义变量,肯定是与接口方法相关,并且是整个应用的基础常量。
正例:
接口方法签名 void commit(); 接口基础常量 String COMPANY = "rydeen";
反例:
接口方法定义 public abstract void f(); 说明:JDK8 +中接口允许有默认实现,那么这个 default 方法,是对所有实现类都有价值的默认实现。
- 【强制】接口和实现类的命名对于 Service 以Impl结尾
正例:CacheServiceImpl 实现 CacheService 接口。
- 【参考】枚举类名建议带上 Enum 后缀,枚举成员名称需要全大写,单词间用下划线隔开。说明:枚举其实就是特殊的类,域成员均为常量,且构造方法被默认强制是私有。
正例:枚举名字为 ProcessStatusEnum 的成员名称:SUCCESS / UNKNOWN_REASON。
- 【参考】各层命名规约:
A) Service/DAO 层方法命名规约
- 获取单个对象的方法用 get 做前缀。
- 获取多个对象的方法用 list 做前缀,复数形式结尾如:listObjects。
- 获取统计值的方法用 count 做前缀。
- 插入的方法用 save/insert 做前缀。
- 删除的方法用 remove/delete 做前缀。
- 修改的方法用 update 做前缀。
B) 领域模型命名规约
- 数据对象:对应表名的Pascal命名,并去除表头的一些无意义缩写和_info后缀。
- 数据传输对象:xxxDTO,xxx 为业务领域相关的名称。
- 展示对象:xxxVO,xxx 一般为网页名称。
- 数据库访问对象:xxxMapper,xxx为业务领域名称,通常和Domain相同。
- POJO 是 DO/DTO/BO/VO 的统称,禁止命名成 xxxPOJO。
(二)常量定义
-
【强制】不允许任何魔法值(即未经预先定义的常量)直接出现在代码中。
-
【强制】在 long 或者 Long 赋值时,数值后使用大写的 L,不能是小写的 l,小写容易跟数字1混淆,造成误解。
-
【强制】不要使用一个常量类维护所有常量,要按常量功能进行归类,分开维护。大而全的常量类,杂乱无章,使用查找功能才能定位到修改的常量,不利于理解和维护。
正例:缓存相关常量放在类 CacheConstants 下;系统配置相关常量放在类 ConfigConstants 下。
反例:
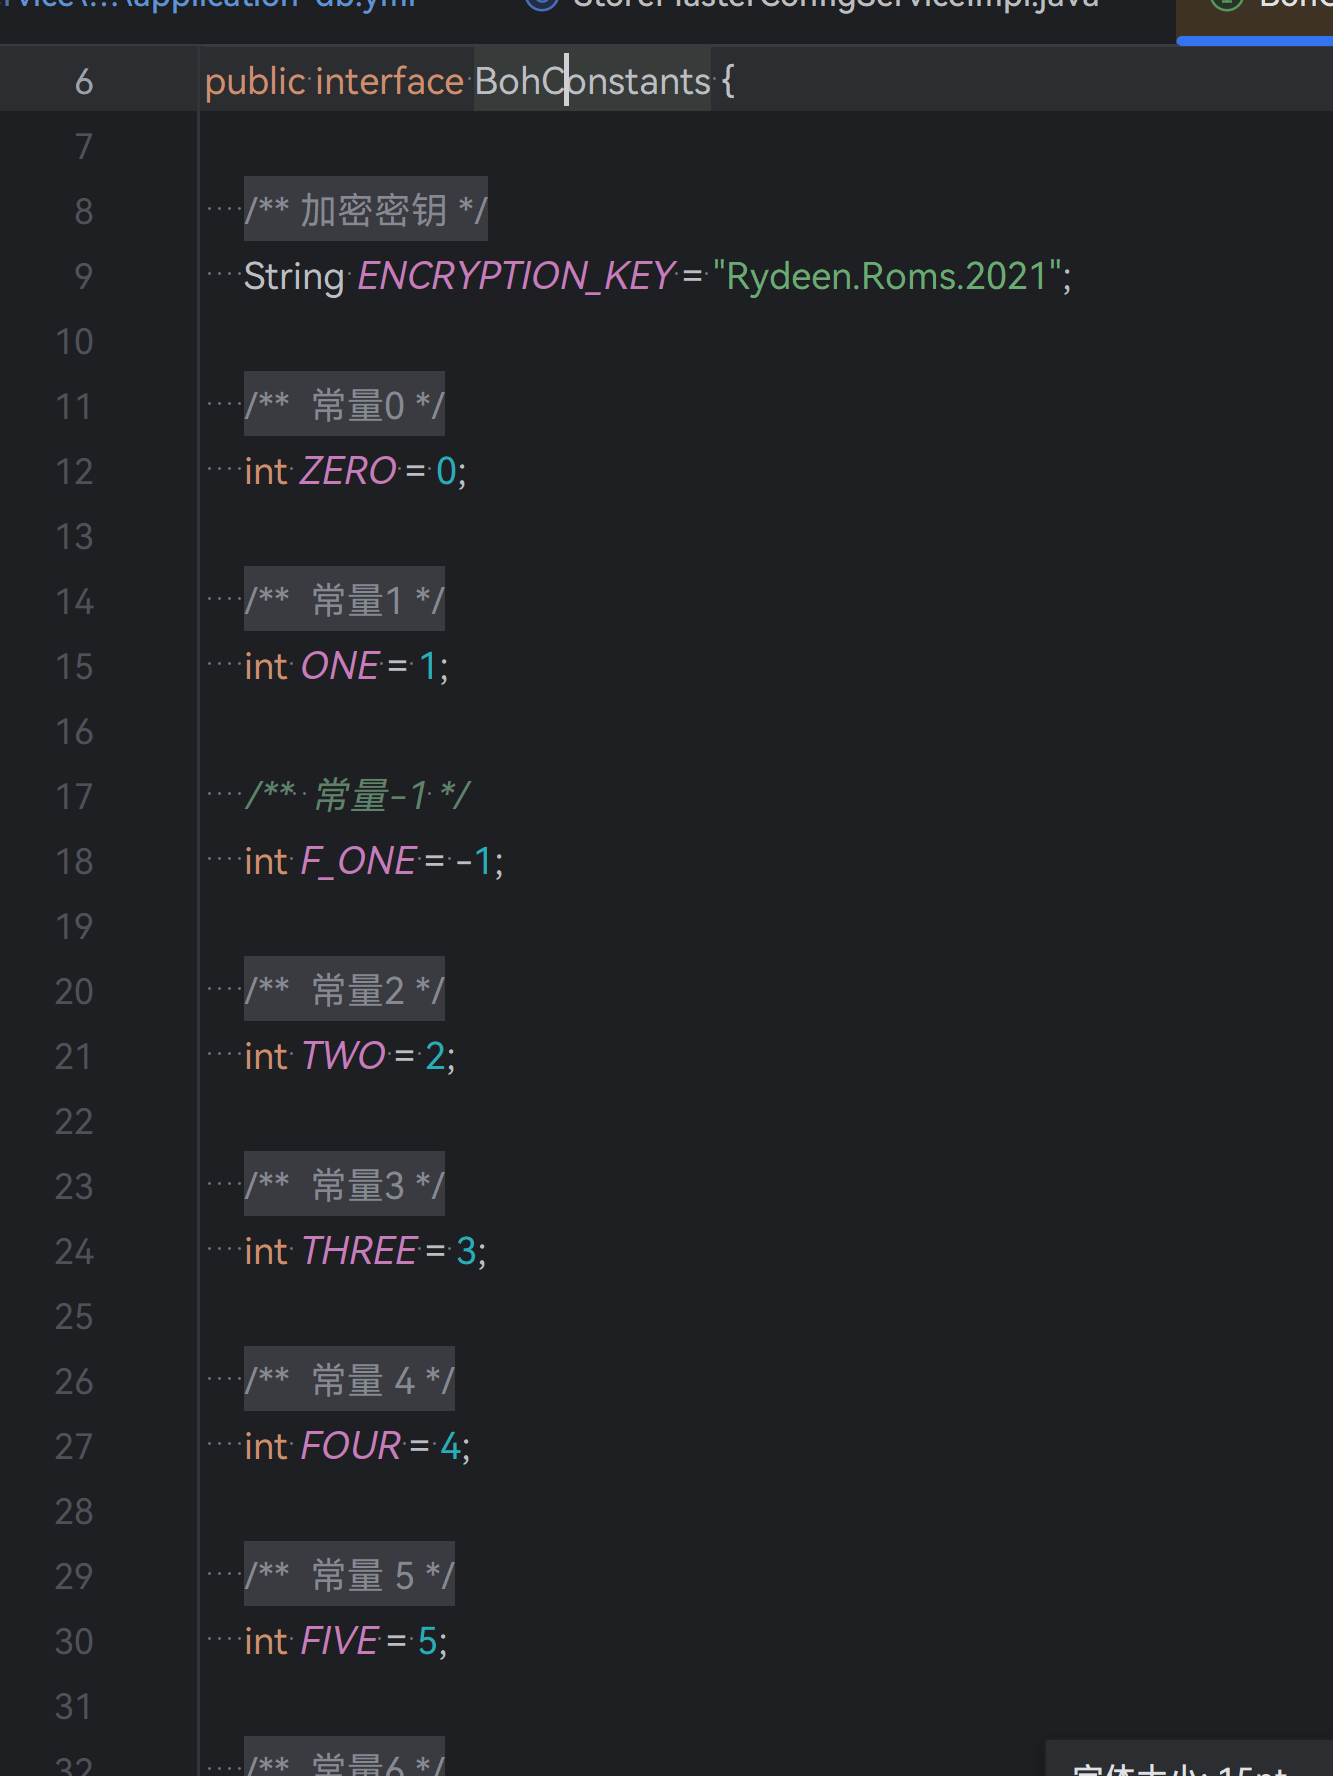
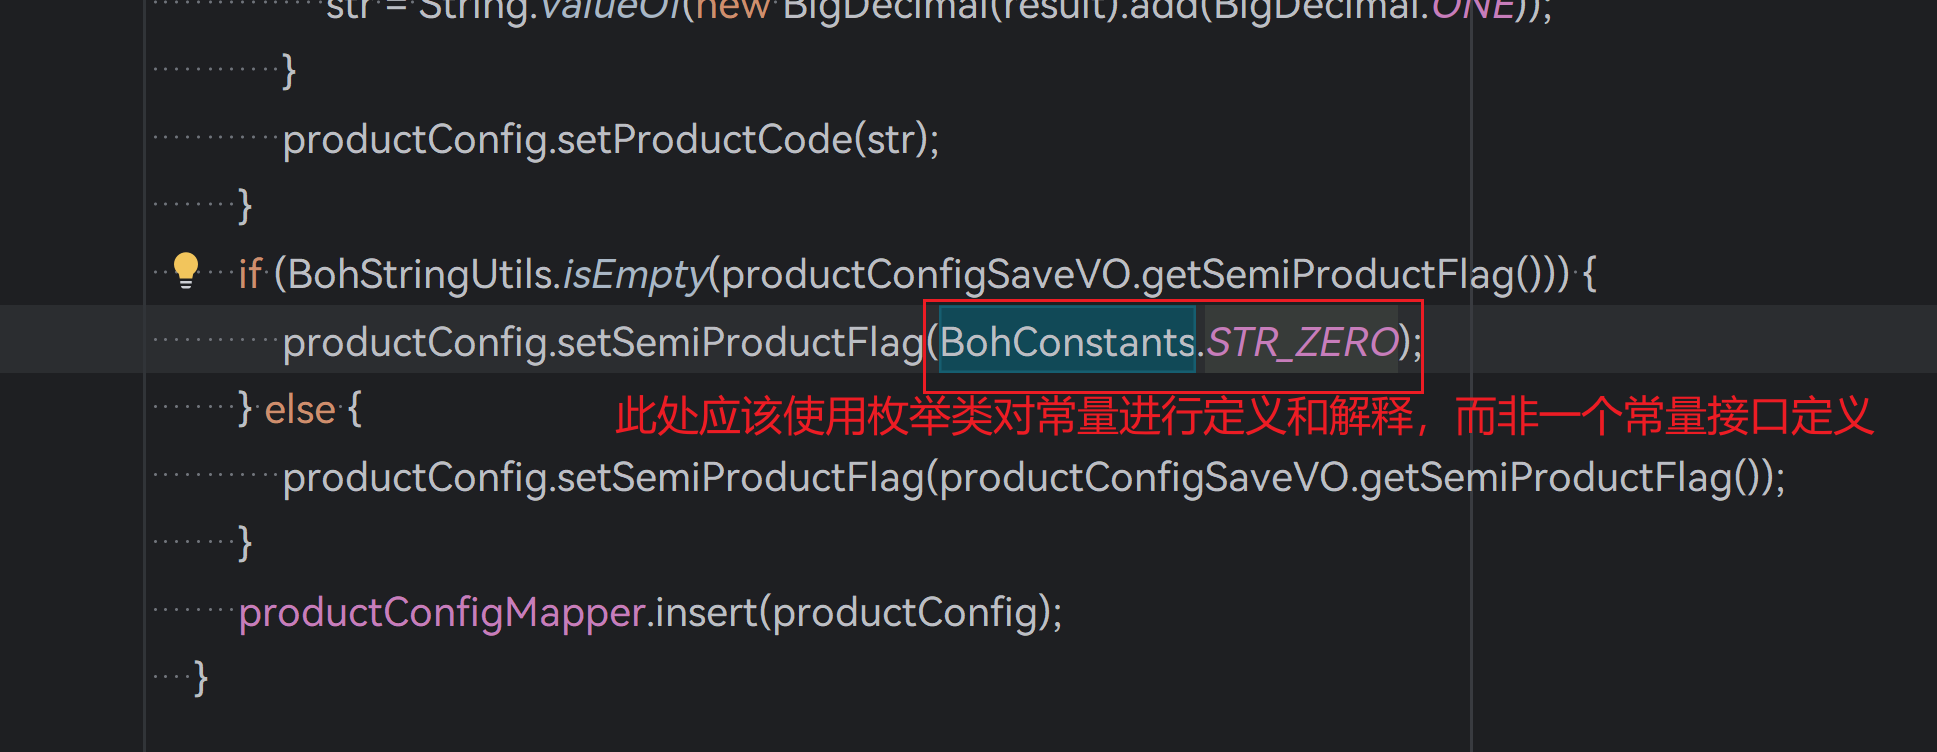
此处使用该方式定义常量,完全无法理解其含义,与直接写“0”的区别就是抽取了一个变量,而该变量的含义在不同的位置具有不同的含义,会导致理解困难。
(三)代码格式
-
【强制】左小括号和右边相邻字符之间不需要空格;右小括号和左边相邻字符之间也不需要空格;而左大括号前需要加空格。详见第 5 条下方正例提示。 反例:if (空格 a == b 空格)
-
【强制】if/for/while/switch/do 等保留字与括号之间都必须加空格。
-
【强制】任何二目、三目运算符的左右两边都需要加一个空格。
说明:运算符包括赋值运算符=、逻辑运算符&&、加减乘除符号等。
-
【强制】采用 4 个空格缩进,禁止使用 tab 字符。
-
【强制】注释的双斜线与注释内容之间有且仅有一个空格。正例:// 这是示例注释,请注意在双斜线之后有一个空格
-
【强制】方法参数在定义和传入时,多个参数逗号后边必须加空格。
正例:下例中实参的 args1,后边必须要有一个空格。
method(args1, args2, args3); -
【推荐】单个方法的总行数不超过 80 行。
正例:代码逻辑分清红花和绿叶,个性和共性,绿叶逻辑单独出来成为额外方法,使主干代码更加清晰;共性逻辑抽取成为共性方法,便于复用和维护。
(四)OOP规约
-
【强制】所有的覆写方法,必须加@Override 注解。
说明:getObject()与 get0bject()的问题。一个是字母的 O,一个是数字的 0,加@Override 可以准确判断是否覆盖成功。另外,如果在抽象类中对方法签名进行修改,其实现类会马上编译报错。
-
【强制】所有的相同类型的包装类对象之间值的比较,全部使用 equals 方法比较。说明:对于 Integer var = ? 在-128 至 127 范围内的赋值,Integer 对象是在 IntegerCache.cache 产生,会复用已有对象,这个区间内的 Integer 值可以直接使用==进行判断,但是这个区间之外的所有数据,都会在堆上产生,并不会复用已有对象,这是一个大坑, 推荐使用 equals 方法进行判断。
-
关于基本数据类型与包装数据类型的使用标准如下:
- 【强制】所有的 POJO 类属性必须使用包装数据类型。
- 【强制】RPC 方法的返回值和参数必须使用包装数据类型。
- 【推荐】所有的局部变量使用基本数据类型。
说明:POJO 类属性没有初值是提醒使用者在需要使用时,必须自己显式地进行赋值,任何 NPE 问题,或者入库检查,都由使用者来保证。
正例:数据库的查询结果可能是 null,因为自动拆箱,用基本数据类型接收有 NPE 风险。反例:比如显示成交总额涨跌情况,即正负 x%,x 为基本数据类型,调用的 RPC 服务,调用不成功时,返回的是默认值,页面显示为 0%,这是不合理的,应该显示成中划线。所以包装数据类型的 null 值,能够表示额外的信息,如:远程调用失败,异常退出。
-
【强制】序列化类新增属性时,请不要修改 serialVersionUID 字段,避免反序列失败;如果完全不兼容升级,避免反序列化混乱,那么请修改 serialVersionUID 值。
说明:注意 serialVersionUID 不一致会抛出序列化运行时异常。
-
【强制】构造方法里面禁止加入任何业务逻辑,如果有初始化逻辑,请放在 init 方法中。
-
【强制】Domain 类必须使用 Lombok 的 @Data 注解,如果集成了其他父类,则需要额外添加一个 @EqualsAndHashCode(callSuper = true)
说明:在方法执行抛出异常时,可以直接调用 POJO 的 toString()方法打印其属性值,便于排查问题。
-
【推荐】使用索引访问用 String 的 split 方法得到的数组时,需做最后一个分隔符后有无内容的检查,否则会有抛 IndexOutOfBoundsException 的风险。
说明:
String str = "a,b,c,,";String[] ary = str.split(",");// 预期大于 3,结果是 3System.out.println(ary.length); -
【推荐】final 可以声明类、成员变量、方法、以及本地变量,下列情况使用 final 关键字:
- 不允许被继承的类,如:String 类,。
- 不允许修改引用的域对象。
- 不允许被重写的方法,如:POJO 类的setter 方法。
- 不允许运行过程中重新赋值的局部变量。
- 避免上下文重复使用一个变量,使用 final 描述可以强制重新定义一个变量,方便更好地进行重构。
-
【推荐】慎用 Object 的 clone 方法来拷贝对象。对象复制推荐使用mapStruct进行拷贝。
说明:对象的 clone 方法默认是浅拷贝,若想实现深拷贝需要重写 clone 方法实现域对象的深度遍历式拷贝。
-
【推荐】当一个类里面的所有属性都是只读的时候,推荐使用JDK17/21 LTS版本中的Record Class进行定义,确保记录类的所有数据都不能被修改。
-
【推荐】当定义的接口需要有多个实现的时候,推荐使用JDK17/21 LTS版本中的Sealed Class进行定义,以保护当前接口不能被随意实现或实现类不能被随意继承,防止业务编码后期对接口提供的功能造成影响。
(五)集合处理
-
【强制】ArrayList 的subList 结果不可强转成ArrayList,否则会抛出ClassCastException异常,即 java.util.RandomAccessSubList cannot be cast to java.util.ArrayList。说明:subList 返回的是 ArrayList 的内部类 SubList,并不是 ArrayList 而是 ArrayList的一个视图,对于 SubList 子列表的所有操作最终会反映到原列表上。
-
【强制】在 subList 场景中,高度注意对原集合元素的增加或删除,均会导致子列表的遍历、增加、删除产生 ConcurrentModificationException 异常。
-
【强制】使用工具类 Arrays.asList()把数组转换成集合时,不能使用其修改集合相关的方法,它的 add/remove/clear 方法会抛出 UnsupportedOperationException 异常。
说明:asList 的返回对象是一个 Arrays 内部类,并没有实现集合的修改方法。Arrays.asList体现的是适配器模式,只是转换接口,后台的数据仍是数组。
String[] str = new String[] { "you", "wu" };List list = Arrays.asList(str);第一种情况:list.add("yangguanbao"); 运行时异常。
第二种情况:str[0] = "gujin"; 那么 list.get(0)也会随之修改。
-
【参考】泛型通配符
<? extends T>来接收返回的数据,此写法的泛型集合不能使用 add 方法,而<? super T>不能使用 get 方法,作为接口调用赋值时易出错。说明:扩展说一下 PECS(Producer Extends Consumer Super)原则: 第一、频繁往外读取内容的,适合用
<? extends T>。 第二、经常往里插入的,适合用<? super T>。 -
【强制】不要在 foreach 循环里进行元素的remove/add 操作。remove 元素请使用 Iterator 方式,如果并发操作,需要对 Iterator 对象加锁。正例:
List<String> list = new ArrayList<>(); list.add("1");list.add("2");Iterator<String> iterator = list.iterator();while (iterator.hasNext()) {String item = iterator.next(); if (删除元素的条件) {iterator.remove();}}反例:
for (String item : list) {if ("1".equals(item)) {list.remove(item);}}说明:以上代码的执行结果肯定会出乎大家的意料,那么试一下把“1”换成“2”,会是同样的结果吗?
-
【参考】利用 Set 元素唯一的特性,可以快速对一个集合进行去重操作,避免使用 List contains 方法进行遍历、对比、去重操作。
-
【推荐】集合泛型定义时,在 JDK7 及以上,使用 diamond 语法或全省略。说明:菱形泛型,即 diamond,直接使用 <> 来指代前边已经指定的类型。 正例:
// <> diamond 方式HashMap<String, String> userCache = new HashMap<>(16); -
【推荐】集合初始化时,指定集合初始值大小。
说明:HashMap 使用 HashMap(int initialCapacity) 初始化。 正例:initialCapacity = (需要存储的元素个数 / 负载因子) + 1。注意负载因子(即 loader factor)默认为 0.75,如果暂时无法确定初始值大小,请设置为 16(即默认值)。 反例:HashMap 需要放置 1024 个元素,由于没有设置容量初始大小,随着元素不断增加,容量 7 次被迫扩大,resize 需要重建 hash 表,严重影响性能。
-
【推荐】使用 entrySet 遍历 Map 类集合KV,而不是 keySet 方式进行遍历。
说明:keySet 其实是遍历了 2 次,一次是转为 Iterator 对象,另一次是从 hashMap 中取出key 所对应的 value。而 entrySet 只是遍历了一次就把 key 和 value 都放到了 entry 中,效率更高。如果是 JDK8,使用 Map.foreach 方法。 正例:values()返回的是 V 值集合,是一个list 集合对象;keySet()返回的是 K 值集合,是一个 Set 集合对象;entrySet()返回的是 K-V 值组合集合。
-
【推荐】高度注意 Map 类集合 K/V 能不能存储 null 值的情况,如下表格:
| 集合类 | Key | Value | Super | 说明 |
|---|---|---|---|---|
| Hashtable | 不允许为 null | 不允许为 null | Dictionary | 线程安全 |
| ConcurrentHashMap | 不允许为 null | 不允许为 null | AbstractMap | 锁分段技术(JDK8:CAS) |
| TreeMap | 不允许为 null | 允许为 null | AbstractMap | 线程不安全 |
| HashMap | 允许为 null | 允许为 null | AbstractMap | 线程不安全 |
反例: 由于 HashMap 的干扰,很多人认为 ConcurrentHashMap 是可以置入 null 值,而事实上, 存储 null 值时会抛出 NPE 异常。
- 【参考】合理利用好集合的有序性(sort)和稳定性(order),避免集合的无序性(unsort)和不稳定性(unorder)带来的负面影响。
说明:有序性是指遍历的结果是按某种比较规则依次排列的。稳定性指集合每次遍历的元素次序是一定的。如:ArrayList 是 order/unsort;HashMap 是 unorder/unsort;TreeSet 是order/sort。
(六)并发处理
-
【强制】获取单例对象需要保证线程安全,其中的方法也要保证线程安全。说明:资源驱动类、工具类、单例工厂类都需要注意。
-
【强制】创建线程或线程池时请指定有意义的线程名称,方便出错时回溯。正例:
public class TimerTaskThread extends Thread {public TimerTaskThread() {super.setName("TimerTaskThread");...}} -
【强制】当需要使用CompletableFuture进行异步线程执行是,请提供自定义线程池,不要使用默认自带的 ForkJoinPool 线程池,否则可能出现线程窃取的问题,线程池定义推荐使用动态线程池实现,具体参考: rydeen-component-threadpool 组件。
-
【强制】当使用Stream流接口中的ParallelStream进行并行流处理时也同上一点相同的原因,提供自定义线程池,以防止出现线程窃取的问题。
-
【强制】线程资源必须通过线程池提供,不允许在应用中自行显式创建线程。
说明:使用线程池的好处是减少在创建和销毁线程上所消耗的时间以及系统资源的开销,解决资源不足的问题。如果不使用线程池,有可能造成系统创建大量同类线程而导致消耗完内存或者“过度切换”的问题。
-
【强制】线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险。但更加推荐使用框架提供的动态线程池组件在配置中心创建动态线程池,具体参考:rydeen-component-threadpool 组件。
说明:Executors 返回的线程池对象的弊端如下:
- FixedThreadPool 和 SingleThreadPool:允许的请求队列长度为 Integer.MAX_VALUE,可能会堆积大量的请求,从而导致 OOM。
- CachedThreadPool 和 ScheduledThreadPool:允许的创建线程数量为 Integer.MAX_VALUE,可能会创建大量的线程,从而导致 OOM。
-
【强制】SimpleDateFormat 是线程不安全的类,一般不要定义为 static 变量,如果定义为 static,必须加锁,或者使用Apache Commons 的 DateUtils 工具类。
正例:注意线程安全,使用 DateUtils。亦推荐如下处理:
private static final ThreadLocal<DateFormat> df = new ThreadLocal<DateFormat>() {@Overrideprotected DateFormat initialValue() {return new SimpleDateFormat("yyyy-MM-dd");}};说明:如果是 JDK8 的应用,可以使用 Instant 代替 Date,LocalDateTime 代替 Calendar, DateTimeFormatter 代替 SimpleDateFormat,官方给出的解释:simple beautiful strong immutable thread-safe。
-
【强制】高并发时,同步调用应该去考量锁的性能损耗。能用无锁数据结构,就不要用锁;能锁区块,就不要锁整个方法体;能用对象锁,就不要用类锁。
说明:尽可能使加锁的代码块工作量尽可能的小,避免在锁代码块中调用 RPC 方法。
-
【强制】对多个资源、数据库表、对象同时加锁时,需要保持一致的加锁顺序,否则可能会造成死锁。
说明:线程一需要对表 A、B、C 依次全部加锁后才可以进行更新操作,那么线程二的加锁顺序也必须是 A、B、C,否则可能出现死锁。
-
【强制】并发修改同一记录时,避免更新丢失,需要加锁。要么在应用层加锁,要么在缓存加锁,要么在数据库层使用乐观锁,使用 version 作为更新依据。
说明:如果每次访问冲突概率小于 20%,推荐使用乐观锁,否则使用悲观锁。乐观锁的重试次数不得小于 3 次。
-
【强制】多线程并行处理定时任务时,Timer 运行多个 TimeTask 时,只要其中之一没有捕获抛出的异常,其它任务便会自动终止运行,使用 ScheduledExecutorService 则没有这个问题。
-
【推荐】使用 CountDownLatch 进行异步转同步操作,每个线程退出前必须调用 countDown 方法,线程执行代码注意 catch 异常,确保 countDown 方法被执行到,避免主线程无法执行至 await 方法,直到超时才返回结果
说明:注意,子线程抛出异常堆栈,不能在主线程 try-catch 到。
-
【推荐】避免 Random 实例被多线程使用,虽然共享该实例是线程安全的,但会因竞争同一 seed 导致的性能下降。推荐使用 ThreadLocalRandom 进行随机数获取
-
【推荐】在并发场景下,通过双重检查锁(double-checked locking)实现延迟初始化的优化问题隐患(可参考 The "Double-Checked Locking is Broken" Declaration),推荐解决方案中较为简单一种(适用于 JDK5 及以上版本),将目标属性声明为 volatile 型。
反例:
class LazyInitDemo {

  private Helper helper = null;

  public Helper getHelper() {
    if (helper == null) {
      synchronized(this) {
        if (helper == null)
          helper = new Helper();
         }
        return helper;
       }
     }
   }
// other methods and fields...
}
- 【参考】volatile 解决多线程内存不可见问题。对于一写多读,是可以解决变量同步问题, 但是如果多写,同样无法解决线程安全问题。如果是 count++操作,使用如下类实现:
AtomicInteger count = new AtomicInteger();
count.addAndGet(1);
-
【参考】 HashMap 在容量不够进行 resize 时由于高并发可能出现死链,导致 CPU 飙升,在开发过程中可以使用其它数据结构或加锁来规避此风险。
-
【参考】ThreadLocal 无法解决共享对象的更新问题,ThreadLocal 对象建议使用 static 修饰。这个变量是针对一个线程内所有操作共享的,所以设置为静态变量,所有此类实例共享此静态变量 ,也就是说在类第一次被使用时装载,只分配一块存储空间,所有此类的对象(只要是这个线程内定义的)都可以操控这个变量。
(七)控制语句
-
【强制】JDK 17/21 的项目请使用 Pattern Switch 新的 JDK API 接口来编写 switch 代码库
-
【强制】在 if/else/for/while/do 语句中必须使用大括号。即使只有一行代码,避免采用单行的编码方式:if (condition) statements;
-
【强制】在高并发场景中,避免使用”等于”判断作为中断或退出的条件。
说明:如果并发控制没有处理好,容易产生等值判断被“击穿”的情况,使用大于或小于的区间判断条件来代替。
反例:判断剩余奖品数量等于 0 时,终止发放奖品,但因为并发处理错误导致奖品数量瞬间变成了负数,这样的话,活动无法终止。
-
【推荐】表达异常的分支时,少用 if-else 方式,这种方式可以改写成:
if (condition) {...return obj;}// 接着写 else 的业务逻辑代码;说明:如果非得使用 if()...else if()...else...方式表达逻辑,【强制】避免后续代码维护困难,请勿超过 3 层。
正例:超过 3 层的 if-else 的逻辑判断代码可以使用卫语句、策略模式、状态模式等来实现, 其中卫语句示例如下:
// 卫语句示例代码public void today() {if (isBusy()) {System.out.println("change time.");return;}if (isFree()) {System.out.println("go to travel.");return;}System.out.println("stay at home to learn Rydeen Java Coding Guidelines.");return;} -
【推荐】除常用方法(如 getXxx/isXxx)等外,不要在条件判断中执行其它复杂的语句,将复杂逻辑判断的结果赋值给一个有意义的布尔变量名,以提高可读性。
说明:很多 if 语句内的逻辑相当复杂,阅读者需要分析条件表达式的最终结果,才能明确什么样的条件执行什么样的语句,那么,如果阅读者分析逻辑表达式错误呢?
正例:
// 伪代码如下final boolean existed = (file.open(fileName, "w") != null) && (...) || (...);if (existed) {...}反例:
if ((file.open(fileName, "w") != null) && (...) || (...)) {...} -
【推荐】避免采用取反逻辑运算符。
说明:取反逻辑不利于快速理解,并且取反逻辑写法必然存在对应的正向逻辑写法。
正例:
if (StringUtils.isNotEmpty(str)) {...}反例:
if (!StringUtils.isEmpty(str)) {...}以此例为引,判断字符串相关工具类接口请使用Apache Commons lang3工具包,不要使用Spring的内部工具包,判断非空推荐使用isBlank或isNotBlank,覆盖的空情况比isEmpty和isNotEmpty更广。
-
【参考】下列情形,需要进行参数校验:
- 调用频次低的方法。
- 执行时间开销很大的方法。此情形中,参数校验时间几乎可以忽略不计,但如果因为参数错误导致中间执行回退,或者错误,那得不偿失。
- 需要极高稳定性和可用性的方法。
- 对外提供的开放接口,不管是 RPC/API/HTTP 接口。
- 敏感权限入口。
-
【参考】下列情形,不需要进行参数校验:
- 极有可能被循环调用的方法。但在方法说明里必须注明外部参数检查要求。
- 底层调用频度比较高的方法。毕竟是像纯净水过滤的最后一道,参数错误不太可能到底层才会暴露问题。一般 DAO 层与 Service 层都在同一个应用中,部署在同一台服务器中,所以 DAO 的参数校验,可以省略。
- 被声明成 private 只会被自己代码所调用的方法,如果能够确定调用方法的代码传入参数已经做过检查或者肯定不会有问题,此时可以不校验参数。
二、异常日志
(一)异常处理
-
【强制】Java 类库中定义的可以通过预检查方式规避的 RuntimeException 异常不应该通过catch 的方式来处理,比如:NullPointerException,IndexOutOfBoundsException 等等。说明:无法通过预检查的异常除外,比如,在解析字符串形式的数字时,不得不通过 catch NumberFormatException 来实现。
正例:
if (obj != null) {...}反例:
try { obj.method(); } catch (NullPointerException e) {...} -
【强制】异常不要用来做流程控制,条件控制。
说明:异常设计的初衷是解决程序运行中的各种意外情况,且异常的处理效率比条件判断方式要低很多。
-
【强制】catch 时请分清稳定代码和非稳定代码,稳定代码指的是无论如何不会出错的代码。对于非稳定代码的 catch 尽可能进行区分异常类型,再做对应的异常处理。
说明:对大段代码进行 try-catch,使程序无法根据不同的异常做出正确的应激反应,也不利于定位问题,这是一种不负责任的表现。
正例:用户注册的场景中,如果用户输入非法字符,或用户名称已存在,或用户输入密码过于简单,在程序上作出分门别类的判断,并提示给用户。
-
【强制】捕获异常是为了处理它,不要捕获了却什么都不处理而抛弃之,如果不想处理它,请将该异常抛给它的调用者。最外层的业务使用者,必须处理异常,将其转化为用户可以理解的内容。
-
【强制】有 try 块放到了事务代码中,catch 异常后,如果需要回滚事务,一定要注意手动回滚事务。
-
【强制】finally 块必须对资源对象、流对象进行关闭,有异常也要做 try-catch,建议使用 try-with-resources 方式。
-
【强制】不要在 finally 块中使用 return。
说明:finally 块中的 return 返回后方法结束执行,不会再执行 try 块中的 return 语句。
-
【强制】捕获异常与抛异常,必须是完全匹配,或者捕获异常是抛异常的父类。
说明:如果预期对方抛的是绣球,实际接到的是铅球,就会产生意外情况。
-
【推荐】方法的返回值可以为 null,不强制返回空集合,或者空对象等,必须添加注释充分说明什么情况下会返回 null 值。
说明:本手册明确防止 NPE 是调用者的责任。即使被调用方法返回空集合或者空对象,对调用者来说,也并非高枕无忧,必须考虑到远程调用失败、序列化失败、运行时异常等场景返回 null 的情况。
-
【推荐】防止 NPE,是程序员的基本修养,注意 NPE 产生的场景:
- 返回类型为基本数据类型,return 包装数据类型的对象时,自动拆箱有可能产生 NPE。反例:
public int func() { return Integer 对象 },如果为 null,自动解箱抛 NPE。- 数据库的查询结果可能为 null。
- 集合里的元素即使 isNotEmpty,取出的数据元素也可能为 null。
- 远程调用返回对象时,一律要求进行空指针判断,防止 NPE。
- 对于 Session 中获取的数据,建议 NPE 检查,避免空指针。
- 级联调用 obj.getA().getB().getC();一连串调用,易产生 NPE。正例:使用 JDK8 的 Optional 类来防止 NPE 问题。
- 当方法体的返回值为数组或集合类型时,推荐调用Map.of(),List.of(), Set.of()等JDK提供的API返回一个只读的空集合;反之再返回null,尽量避免NPE的情况出现。
-
【参考】避免出现重复的代码(Don’t Repeat Yourself),即 DRY 原则。
-
说明:随意复制和粘贴代码,必然会导致代码的重复,在以后需要修改时,需要修改所有的副本,容易遗漏。必要时抽取共性方法,或者抽象公共类,甚至是组件化。
正例:一个类中有多个 public 方法,都需要进行数行相同的参数校验操作,这个时候请抽取:
private boolean checkParam(DTO dto) {...}
(二)日志规约
-
【强制】应用中不可直接使用日志系统(Log4j、Logback)中的 API,而应依赖使用日志框架SLF4J 中的 API,使用门面模式的日志框架,有利于维护和各个类的日志处理方式统一。推荐使用lombok的@Slf4j的注解
-
【强制】应用中的扩展日志(如打点、临时监控、访问日志等)命名方式:
appName_logType_logName.log。
logType:日志类型,如 stats/monitor/access 等;logName:日志描述。这种命名的好处: 通过文件名就可知道日志文件属于什么应用,什么类型,什么目的,也有利于归类查找。
正例:mppserver 应用中单独监控时区转换异常,如:mppserver_monitor_timeZoneConvert.log
说明:推荐对日志进行分类,如将错误日志和业务日志分开存放,便于开发人员查看,也便于通过日志对系统进行及时监控。
-
【强制】对 trace/debug/info 级别的日志输出,必须使用条件输出形式或者使用占位符的方式。
说明:logger.debug("Processing trade with id: " + id + " and symbol: " + symbol); 如果日志级别是 warn,上述日志不会打印,但是会执行字符串拼接操作,如果 symbol 是对象,会执行 toString()方法,浪费了系统资源,执行了上述操作,最终日志却没有打印。
正例:(条件)建设采用如下方式
if (logger.isDebugEnabled()) {logger.debug("Processing trade with id: " + id + " and symbol: " + symbol);}正例:(占位符)
logger.debug("Processing trade with id: {} and symbol : {} ", id, symbol); -
【强制】异常信息应该包括两类信息:案发现场信息和异常堆栈信息。如果不处理,那么通过关键字 throws 往上抛出。
-
【推荐】谨慎地记录日志。生产环境禁止输出 debug 日志;有选择地输出 info 日志;如果使用 warn 来记录刚上线时的业务行为信息,一定要注意日志输出量的问题,避免把服务器磁盘撑爆,并记得及时删除这些观察日志。
说明:大量地输出无效日志,不利于系统性能提升,也不利于快速定位错误点。记录日志时请思考:这些日志真的有人看吗?看到这条日志你能做什么?能不能给问题排查带来好处?
-
【推荐】可以使用 warn 日志级别来记录用户输入参数错误的情况,避免用户投诉时,无所适从。如非必要,请不要在此场景打出 error 级别,避免频繁报警。
说明:注意日志输出的级别,error 级别只记录系统逻辑出错、异常或者重要的错误信息。
-
【推荐】尽量用英文来描述日志错误信息,如果日志中的错误信息用英文描述不清楚的话使用中文描述即可,否则容易产生歧义。国际化团队或海外部署的服务器由于字符集问题,【强制】使用全英文来注释和描述日志错误信息。
三、安全规约
-
【强制】隶属于用户个人的页面或者功能必须进行权限控制校验。
说明:防止没有做水平权限校验就可随意访问、修改、删除别人的数据,比如查看他人的私信内容、修改他人的订单。
-
【强制】用户敏感数据禁止直接展示,必须对展示数据进行脱敏。
说明:中国大陆个人手机号码显示为:158****9119,隐藏中间 4 位,防止隐私泄露。
-
【强制】用户请求传入的任何参数必须做有效性验证。说明:忽略参数校验可能导致:
- 恶意 order by 导致数据库慢查询
- 任意重定向
- SQL 注入
- 反序列化注入
说明:Java 代码用正则来验证客户端的输入,有些正则写法验证普通用户输入没有问题, 但是如果攻击人员使用的是特殊构造的字符串来验证,有可能导致死循环的结果。
-
【强制】在使用平台资源,譬如短信、邮件、电话、下单、支付,必须实现正确的防重放的机制,如数量限制、疲劳度控制、验证码校验,避免被滥刷而导致资损。
说明:如注册时发送验证码到手机,如果没有限制次数和频率,那么可以利用此功能骚扰到其它用户,并造成短信平台资源浪费。
四、MySQL 数据库
(一)建表规约
-
【强制】表名、字段名必须使用小写字母或数字禁止出现数字开头,禁止两个下划线中间只出现数字。
-
【强制】禁用保留字,如 desc、range、match、delayed 等,请参考 MySQL 官方保留字。
-
【强制】小数类型为 decimal,禁止使用 float 和 double。
说明:float 和 double 在存储的时候,存在精度损失的问题,很可能在值的比较时,得到不正确的结果。如果存储的数据范围超过 decimal 的范围,建议将数据拆成整数和小数分开存储。
-
【强制】varchar 是可变长字符串,不预先分配存储空间,长度不要超过 5000,如果存储长度大于此值,定义字段类型为 text,独立出来一张表,用主键来对应,避免影响其它字段索引效率。
-
【强制】表必备字段:id。建议使用分布式雪花算法作为主键,而不是以递增或者uuid作为主键。
-
【推荐】表的命名最好是加上“业务名称_表的作用”。
-
【推荐】库名与应用名称尽量一致。
-
【推荐】如果修改字段含义或对字段表示的状态追加时,需要及时更新字段注释。
-
【推荐】字段允许适当冗余,以提高查询性能,但必须考虑数据一致。冗余字段应遵循:
- 不是频繁修改的字段。
- 不是 varchar 超长字段,更不能是 text 字段。
正例:商品类目名称使用频率高,字段长度短,名称基本一成不变,可在相关联的表中冗余存储类目名称,避免关联查询。
-
【推荐】单表行数超过 500 万行或者单表容量超过 2GB,才推荐进行分库分表。
说明:如果预计三年后的数据量根本达不到这个级别,请不要在创建表时就分库分表。
- 【参考】合适的字符存储长度,不但节约数据库表空间、节约索引存储,更重要的是提升检索速度。
正例:如下表,其中无符号值可以避免误存负数,且扩大了表示范围。
| 对象 | 年龄区间 | 类型 | 字节 | 表示范围 |
|---|---|---|---|---|
| 人 | 150 岁之内 | tinyint unsigned | 1 | 无符号值:0 到 255 |
| 龟 | 数百岁 | smallint unsigned | 2 | 无符号值:0 到 65535 |
| 恐龙化石 | 数千万年 | int unsigned | 4 | 无符号值:0 到约 42.9 亿 |
| 太阳 | 约 50 亿年 | bigint unsigned | 8 | 无符号值:0 到约 10 的 19 次方 |
(二)索引规约
-
【强制】业务上具有唯一特性的字段,即使是多个字段的组合,也必须建成唯一索引。
说明:不要以为唯一索引影响了 insert 速度,这个速度损耗可以忽略,但提高查找速度是明显的;另外,即使在应用层做了非常完善的校验控制,只要没有唯一索引,根据墨菲定律,必然有脏数据产生。
-
【强制】超过三个表禁止 join。需要 join 的字段,数据类型必须绝对一致;多表关联查询时, 保证被关联的字段需要有索引。
说明:即使双表 join 也要注意表索引、SQL 性能。
-
【强制】在 varchar 字段上建立索引时,必须指定索引长度,没必要对全字段建立索引,根据实际文本区分度决定索引长度即可。
说明:索引的长度与区分度是一对矛盾体,一般对字符串类型数据,长度为 20 的索引,区分度会高达 90%以上,可以使用count(distinct left(列名, 索引长度))/count(*)的区分度来确定。
-
【推荐】如果有 order by 的场景,请注意利用索引的有序性。order by 最后的字段是组合索引的一部分,并且放在索引组合顺序的最后,避免出现 file_sort 的情况,影响查询性能。正例:where a=? and b=? order by c; 索引:a_b_c
反例:索引中有范围查找,那么索引有序性无法利用,如:WHERE a>10 ORDER BY b; 索引 a_b 无法排序。
-
【推荐】利用覆盖索引来进行查询操作,避免回表。
说明:如果一本书需要知道第 11 章是什么标题,会翻开第 11 章对应的那一页吗?目录浏览一下就好,这个目录就是起到覆盖索引的作用。
正例:能够建立索引的种类分为主键索引、唯一索引、普通索引三种,而覆盖索引只是一种查询的一种效果,用 explain 的结果,extra 列会出现:using index。
-
【推荐】利用延迟关联或者子查询优化超多分页场景。
说明:MySQL 并不是跳过 offset 行,而是取 offset+N 行,然后返回放弃前 offset 行,返回N 行,那当 offset 特别大的时候,效率就非常的低下,要么控制返回的总页数,要么对超过特定阈值的页数进行 SQL 改写。
正例:先快速定位需要获取的 id 段,然后再关联:
SELECT a.* FROM 表 1 a, (select id from 表 1 where 条件 LIMIT 100000,20 ) b where a.id=b.id -
【推荐】SQL 性能优化的目标:至少要达到 range 级别,要求是 ref 级别,如果可以是 consts 最好。说明:
- consts 单表中最多只有一个匹配行(主键或者唯一索引),在优化阶段即可读取到数据。
- ref 指的是使用普通的索引(normal index)。
- range 对索引进行范围检索。
反例:explain 表的结果,type=index,索引物理文件全扫描,速度非常慢,这个 index 级别比较 range 还低,与全表扫描是小巫见大巫。
-
【推荐】建组合索引的时候,区分度最高的在最左边。
正例:如果 where a=? and b=? ,如果a 列的几乎接近于唯一值,那么只需要单建 idx_a 索引即可。
说明:存在非等号和等号混合时,在建索引时,请把等号条件的列前置。如:where c>? and d=? 那么即使 c 的区分度更高,也必须把 d 放在索引的最前列,即索引 idx_d_c。
-
【参考】创建索引时避免有如下极端误解:
- 宁滥勿缺。认为一个查询就需要建一个索引。
- 宁缺勿滥。认为索引会消耗空间、严重拖慢更新和新增速度。
- 抵制惟一索引。认为业务的惟一性一律需要在应用层通过“先查后插”方式解决。
-
【推荐】防止因字段类型不同造成的隐式转换,导致索引失效
(三)SQL语句
-
【强制】不要使用 count(列名)或 count(常量)来替代 count(*),count(*)是 SQL92 定义的标准统计行数的语法,跟数据库无关,跟 NULL 和非 NULL 无关。
说明:count(*)会统计值为 NULL 的行,而 count(列名)不会统计此列为 NULL 值的行。
-
【强制】count(distinct col) 计算该列除 NULL 之外的不重复行数,注意 count(distinct col1, col2) 如果其中一列全为 NULL,那么即使另一列有不同的值,也返回为 0。
-
【强制】当某一列的值全是 NULL 时,count(col)的返回结果为 0,但 sum(col)的返回结果为NULL,因此使用 sum()时需注意 NPE 问题。
正例:可以使用如下方式来避免 sum 的 NPE 问题:SELECT IF(ISNULL(SUM(g)),0,SUM(g)) FROM table;
-
【强制】使用 ISNULL()来判断是否为 NULL 值。说明:NULL 与任何值的直接比较都为 NULL。
- NULL<>NULL 的返回结果是 NULL,而不是 false。
- NULL=NULL 的返回结果是 NULL,而不是 true。
- NULL<>1 的返回结果是 NULL,而不是 true。
-
【强制】不得使用外键与级联,一切外键概念必须在应用层解决。
说明:以学生和成绩的关系为例,学生表中的 student_id 是主键,那么成绩表中的 student_id 则为外键。如果更新学生表中的 student_id,同时触发成绩表中的 student_id 更新,即为级联更新。外键与级联更新适用于单机低并发,不适合分布式、高并发集群;级联更新是强阻塞,存在数据库更新风暴的风险;外键影响数据库的插入速度。
-
【强制】禁止使用存储过程,存储过程难以调试和扩展,更没有移植性。
-
【强制】数据订正(特别是删除、修改记录操作)时,要先 select,避免出现误删除,确认无误才能执行更新语句。
-
【推荐】in 操作能避免则避免,若实在避免不了,需要仔细评估 in 后边的集合元素数量,控制在 1000 个之内。
-
【参考】如果有国际化需要,所有的字符存储与表示,均以 utf-8 编码,注意字符统计函数的区别。
说明: SELECT LENGTH("轻松工作"); 返回为 12 SELECT CHARACTER_LENGTH("轻松工作"); 返回为 4 如果需要存储表情,那么选择 utf8mb4 来进行存储,注意它与 utf-8 编码的区别。
-
【参考】TRUNCATE TABLE 比 DELETE 速度快,且使用的系统和事务日志资源少,但 TRUNCATE无事务且不触发 trigger,有可能造成事故,故不建议在开发代码中使用此语句。说明:TRUNCATE TABLE 在功能上与不带 WHERE 子句的 DELETE 语句相同。
(四)ORM映射
- 【强制】sql.xml 配置参数使用:#,#param# 不要使用$ 此种方式容易出现 SQL 注入。
- 【强制】不允许直接拿 HashMap 与 Hashtable 作为查询结果集的输出,必须要使用类。
- 【强制】更新数据表记录时,必须同时更新记录对应的 update_time字段值为当前时间。
- 【强制】@Transactional 事务不要滥用,不要使用过大的事务。
- 【推荐】简单语句推荐使用mybatis-plus的lambda语法实现增删改查
- 【推荐】不要写一个大而全的数据更新接口。传入为 POJO 类,不管是不是自己的目标更新字段,都进行 update table set c1=value1,c2=value2,c3=value3; 这是不对的。执行 SQL 时,不要更新无改动的字段,一是易出错;二是效率低;三是增加 binlog 存储。
五、工程结构
-
【强制】POM 内 dependencies 新依赖的定义(即包含 version 坐标的)必须定义在 dependenciesManagement 中,然后在 dependencies 中引用(引用时严禁编写 version 坐标)
正例:
<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"><modelVersion>4.0.0</modelVersion><dependencyManagement><dependencies><!-- SQL监控 --><dependency><groupId>com.github.gavlyukovskiy</groupId><artifactId>p6spy-spring-boot-starter</artifactId><version>${p6spy-spring-boot-starter.version}</version></dependency></dependencies></dependencyManagement><dependencies><dependency><groupId>com.github.gavlyukovskiy</groupId><artifactId>p6spy-spring-boot-starter</artifactId></dependency></dependencies></project> -
【强制】POM 内需要定义新依赖坐标时,version 坐标只能定义在项目的 dependencies 模块中的 节点中,并在项目中引用,严禁定义在任何其他位置,更不能定义同一个依赖的多个版本,每一个依赖 正例:
<?xml version="1.0" encoding="UTF-8"?><project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"><modelVersion>4.0.0</modelVersion><properties><p6spy-spring-boot-starter.version>1.9.0</p6spy-spring-boot-starter.version></properties><dependencyManagement><dependencies><!-- SQL监控 --><dependency><groupId>com.github.gavlyukovskiy</groupId><artifactId>p6spy-spring-boot-starter</artifactId><version>${p6spy-spring-boot-starter.version}</version></dependency></dependencies></dependencyManagement><dependencies><dependency><groupId>com.github.gavlyukovskiy</groupId><artifactId>p6spy-spring-boot-starter</artifactId></dependency></dependencies></project>
六、系统性能规约
-
【强制】Redis中存储的KEY必须设置过期时间,避免长期占用内存。
-
【强制】Redis中存储的KEY大小不得超过如下的阈值,否则视为BigKey:
- string: 10KB
- list: 数量1000以上,或KEY的总大小超过100KB
- set: 数量1000以上,或KEY的总大小超过100KB
- zset: 数量1000以上,或KEY的总大小超过100KB
- hash: 数量100以上,或KEY的总大小超过100KB
-
【强制】Java当中需要存入Redis中的POJO对象(简单Bean定义:仅包含基础数据类型的变量)请勿包含复杂对象,如List、Map、Set和外键对象等,以避免序列化和反序列化时的性能损耗,以及形成Redis的BigKey,对象类型存入Redis的时候请使用Hash结构进行存储,请勿序列化成字符串。当需要获取或更新对象中的某个属性时请使用
GlobalCache中针对hashValue更新的方法,不要直接获取整个对象再更新。 -
【强制】
-
【强制】